Détection multimodale de l'agitation
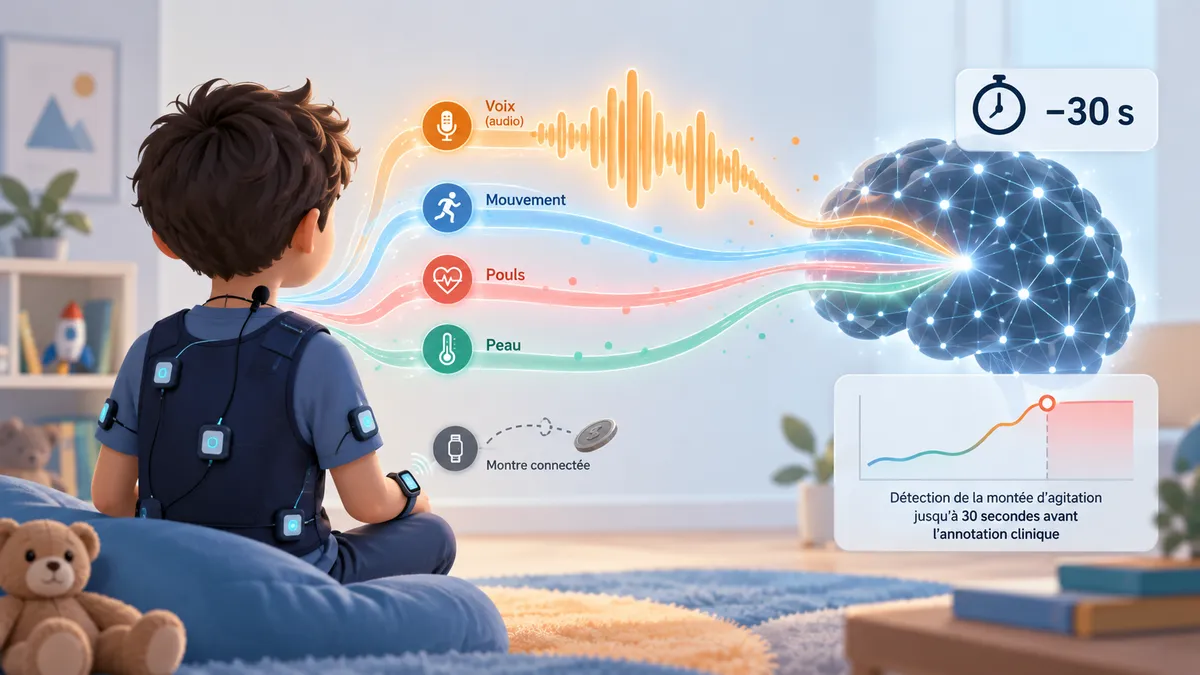
Imaginez une salle de thérapie. Un enfant joue, un clinicien observe. Puis quelque chose bascule : un objet préféré est retiré, une consigne pénible arrive. Pendant quelques secondes, rien de spectaculaire. Une respiration qui change, un regard qui se détourne, une main qui se crispe. Trente secondes plus tard, ce sont des cris, des coups, parfois des gestes d'automutilation. Entre les deux, il y a un moment que les cliniciens appellent l'agitation : une montée de détresse que l'on ne voit que si l'on sait exactement quoi regarder, et qui, pour sa part invisible, ne se voit pas du tout.
C'est cette fenêtre de quelques dizaines de secondes qu'une équipe de l'université Vanderbilt et de l'université d'État de Caroline du Nord a tenté de capturer avec des capteurs portés et des modèles d'IA préentraînés. Leur papier, Detecting Agitation Before Behavioral Escalation in Autistic Youth Through Multimodal Wearable Sensing, déposé sur arXiv le 21 septembre 2026, raconte une étude modeste par la taille mais riche en enseignements. Et il réserve une surprise : la montre connectée, star de tous les récits sur la santé mesurée, y fait à peine mieux qu'une pièce lancée en l'air.
L'agitation, cet orage que l'on ne voit pas venir
Aux États-Unis, environ un enfant sur 31 reçoit un diagnostic d'autisme. Parmi les jeunes autistes, 68 % présentent ce que la littérature appelle des challenging behaviors, comportements-défis en français : agressions, automutilation, destruction d'objets. Ces épisodes mettent en danger l'enfant lui-même comme les personnes qui l'entourent, et ils pèsent lourdement sur les familles et les équipes soignantes.
Les auteurs soulignent que ces crises ne surgissent pas de nulle part. Elles sont précédées d'une phase d'agitation qui se manifeste sur trois canaux à la fois : le mouvement, la vocalisation et l'activation autonome (autonomic arousal), c'est-à-dire la réponse du système nerveux qui accélère le cœur, fait transpirer les paumes et prépare le corps à réagir. Le problème est double. D'une part, les signes sont subtils et très individuels : ce qui annonce la crise chez un enfant ne veut rien dire chez un autre. D'autre part, la composante autonome est tout simplement invisible à l'œil nu. Aucun clinicien, aussi expérimenté soit-il, ne voit une conductance cutanée grimper.
D'où l'idée d'instrumenter : mettre des capteurs là où l'humain ne peut pas regarder, et demander à un modèle d'apprendre, pour chaque enfant, à quoi ressemble sa propre montée en tension.
Un gilet, une montre, un micro : le protocole
L'équipe a recruté 15 jeunes autistes, âgés de 3 ans et 4 mois à 17 ans et 5 mois. Chacun a participé à deux sessions dans une suite clinique à deux pièces, soit 30 sessions au total. Chaque session suit un schéma inspiré de l'analyse appliquée du comportement : une phase de renforcement où l'enfant a accès à ce qu'il aime, puis une opération établissante (establishing operation), condition individualisée conçue pour provoquer une agitation légère, comme retirer un objet préféré ou introduire une demande désagréable. Dès la première manifestation d'agitation, on revient au renforcement. Le tout est supervisé par un analyste du comportement certifié, avec un plan de sécurité prédéfini et un droit de pause ou de retrait rappelé à chaque famille.
Côté matériel, trois familles de capteurs :
- le mouvement, via cinq centrales inertielles Bosch BNO055 à 100 Hz, placées aux deux poignets, aux deux bras et au torse, intégrées dans un gilet conçu sur mesure. Une étude préliminaire de confort avec 7 jeunes autistes et 6 aidants avait guidé le choix des tissus doux, des poches internes et des fixations prévisibles ;
- la physiologie, via un boîtier EmotiBit porté au poignet ou à la cheville, qui mesure l'activité électrodermale à 15 Hz et la photopléthysmographie (le petit capteur optique qui lit le pouls) entre 25 et 50 Hz. Seuls 7 des 15 participants ont accepté de le porter, ce qui aura son importance ;
- la voix, via un micro-cravate sans fil échantillonné à 48 kHz.
Ensuite vient le travail le plus fastidieux et le plus précieux : l'annotation. Des techniciens comportementaux ont visionné a posteriori chaque session à partir de quatre webcams synchronisées, sur une plateforme maison permettant de naviguer image par image, et ont marqué le moment où l'agitation devient visible. L'accord entre annotateurs, mesuré sur 20 % des sessions, dépasse un kappa de Cohen de 0,85, avec une tolérance d'une seconde. Selon les enfants, on compte de 58 à 366 événements d'agitation, pour un total de 2 215.
Les auteurs font de ce point une hypothèse explicite de modélisation : l'instant annoté marque le moment où un humain voit le premier signe. C'est donc une borne supérieure du vrai début de l'agitation, qui a pu commencer bien avant sur les canaux invisibles. Toute l'idée de « détecter avant » repose sur ce décalage.
Quatre oreilles expertes et un espéranto à 128 dimensions
Avec 15 enfants et quelques heures d'enregistrement, on est très loin des volumes de données qui permettent d'entraîner un réseau de neurones à partir de zéro. L'équipe a donc fait le choix de l'apprentissage par transfert (transfer learning) : au lieu d'apprendre à écouter, à sentir un pouls ou à lire un mouvement depuis rien, on recrute des modèles qui savent déjà le faire.
Il y a donc quatre modèles de fondation (foundation models), un par modalité :
- pour le mouvement, un réseau graphique spatio-temporel préentraîné sur de nombreux jeux de données d'activité humaine, qui produit une représentation en 512 dimensions ;
- pour l'audio, EfficientAT, un réseau convolutif entraîné sur AudioSet, l'immense catalogue de sons de YouTube, en 960 dimensions ;
- pour le pouls, PaPaGei, un modèle auto-supervisé dédié à la photopléthysmographie, en 512 dimensions ;
- pour l'activité électrodermale, UME, un réseau convolutif entraîné sur des corpus de capteurs de peau, en 64 dimensions.
Pensez à quatre spécialistes qui parlent chacun leur langue. Pour qu'ils puissent délibérer ensemble, il faut un espéranto commun. C'est le rôle de la projection : chaque représentation, concaténée avec une poignée de caractéristiques calculées à la main (vitesse et saccades du mouvement, pente de la conductance cutanée, variabilité cardiaque, énergie et timbre de la voix), est ramenée par une couche linéaire à un espace partagé de 128 dimensions. Les quatre vecteurs sont ensuite mis bout à bout dans un bloc de fusion, qui rend un verdict binaire : agitation ou non.
Le tout fonctionne sur des fenêtres de 15 secondes. Pour chaque événement annoté, la fenêtre positive est celle qui se termine exactement à l'instant d'annotation ; les fenêtres négatives sont prélevées dans les périodes calmes situées à au moins 15 secondes de tout événement.
Reste la question de l'individualisation. Faut-il un modèle par enfant, puisque chaque agitation est unique ? Les auteurs ont testé les deux. Leur modèle de groupe (group model) garde un tronc commun pour tous les participants, et n'ajoute qu'une petite tête linéaire par enfant, sélectionnée par identité. Même orchestre, mais chacun son pupitre. Pour les enfants sans montre, les entrées physiologiques sont simplement masquées à zéro.
Trois régimes d'entraînement ont été comparés. En mode figé (frozen), les modèles de fondation ne bougent pas, on n'entraîne que les projections, la fusion et les têtes. En mode affiné (fine-tuned), on leur ajoute des adaptateurs de bas rang, la fameuse technique LoRA, quelques centaines de milliers de paramètres glissés dans les couches comme des post-it dans un manuel. En mode à partir de zéro (from scratch), même architecture, mais poids aléatoires.
La validation est souvent le point où les études sur séries temporelles se piègent. Deux fenêtres voisines de quelques secondes se ressemblent énormément : si l'une sert à entraîner et l'autre à tester, le modèle « triche » sans le vouloir. L'équipe a donc utilisé une validation croisée par blocs chronologiques : les sessions de chaque enfant sont découpées en cinq blocs contigus dans le temps, et chaque bloc sert de test à tour de rôle. Les statistiques de normalisation sont calculées uniquement sur les blocs d'entraînement. On ne révise pas avec les réponses du lendemain.
Ce que le modèle a réellement vu venir
La métrique principale est l'AUC (area under the ROC curve). Une façon simple de la lire : si l'on tire au hasard une fenêtre d'agitation et une fenêtre calme, l'AUC est la probabilité que le modèle attribue un score plus élevé à la première. Une pièce de monnaie donne 0,5 ; un oracle parfait, 1.
Le modèle de groupe affiné obtient une AUC de 0,724 à l'instant annoté, avec un intervalle de confiance à 95 % allant de 0,650 à 0,794. Un test de permutation intra-participant, qui mélange les étiquettes de chaque enfant pour voir ce que donnerait le hasard, renvoie une valeur p de 0,0005. Treize des quinze participants dépassent le hasard ; deux restent au niveau de la pièce de monnaie.
Vient ensuite la question qui donne son titre au papier : et avant l'annotation ? Les auteurs ont décalé la fenêtre d'entrée de 5 à 30 secondes en amont de l'instant annoté, en conservant l'étiquette « agitation ». Les performances décroissent en pente douce plutôt qu'en falaise : 0,724 à l'instant zéro, 0,632 à 15 secondes, 0,608 à 30 secondes avant. Le modèle reste au-dessus du hasard sur tout l'horizon. Autrement dit, dans des fenêtres qu'aucun humain n'a étiquetées comme agitées, quelque chose est déjà détectable.
Les auteurs eux-mêmes tempèrent : cette détection précoce pourrait n'être en partie que de l'autocorrélation, l'état de l'enfant à 30 secondes ressemblant simplement à son état à zéro seconde. Ils proposent, comme piste, une relecture clinique prospective des fenêtres signalées.
La surprise : le micro fait le travail, la montre décroche
Pour mesurer la contribution de chaque capteur, l'équipe a retiré les modalités une à une. Sans mouvement, l'AUC perd 0,020. Sans activité électrodermale ou sans pouls, la perte est inférieure à 0,02, dans le bruit. Sans audio, elle chute de 0,126. Le micro-cravate à quelques dizaines d'euros porte l'essentiel du signal.
Plus frappant encore : chez les 7 enfants équipés de la montre, une configuration montre seule (watch-only), avec électrodermal, pouls et accélération du poignet, plafonne à 0,560, contre 0,699 pour le modèle complet sur ces mêmes enfants. Deux des sept passent même sous le hasard. Le dispositif le plus discret, le plus déployable, celui dont on rêve pour la vie quotidienne, est aussi celui qui n'entend presque rien.
Cette moyenne cache une forte hétérogénéité. La perte liée au retrait de l'audio varie de 0,036 à 0,351 selon l'enfant. Les jeunes dont l'agitation se traduit par des vocalisations nettes ou des mouvements discrets sont bien séparés (AUC de 0,813 et 0,786 respectivement) ; ceux dont les signes sont diffus, changements posturaux subtils ou repli affectif, tombent à 0,731. Et la corrélation avec le profil n'est pas mécanique : le participant 13, qui crie fort et donne des coups de pied vigoureux, passe sous le hasard, tandis que le participant 14, très vocal, reste mal détecté.
L'explication que les auteurs privilégient tient à la qualité des exemples négatifs. Pour 8 enfants, les fenêtres calmes proviennent d'une phase de base cliniquement vérifiée ; pour les 7 autres, d'un simple indicateur d'activation plus faible. Les premiers atteignent en moyenne 0,776, les seconds 0,665. La différence n'est pas statistiquement significative avec si peu d'enfants, mais elle rappelle une vérité d'atelier : un classifieur apprend autant de ce qu'on lui montre comme « normal » que de ce qu'on lui montre comme « anormal ».
Un modèle pour tous plutôt qu'un modèle par enfant
La configuration à partir de zéro plafonne à 0,583, contre 0,708 en mode figé et 0,724 en mode affiné. Le gain de l'affinage sur le gel, 0,016, tient dans l'intervalle de confiance. La lecture des auteurs est nette : la majeure partie du signal détectable réside dans les représentations génériques apprises ailleurs, sur des millions de sons et de mouvements sans rapport avec l'autisme. Cette cohorte n'aurait pas suffi à les apprendre, et elle n'a presque rien à leur ajouter.
Quant à l'individualisation, le modèle de groupe bat sa version par enfant chez 11 participants sur 15, avec une marge moyenne de 0,02 AUC. L'individualité de l'agitation, si réelle soit-elle, semble tenir dans une petite tête personnalisée posée sur un tronc partagé. C'est une bonne nouvelle pratique : un seul modèle à entraîner, à maintenir, à auditer.
Pourquoi ce papier compte
D'abord parce qu'il pose une question clinique concrète avec une rigueur rare dans le domaine des capteurs portés : annotation double avec accord mesuré, validation chronologique qui évite les fuites, test de permutation par enfant, intervalles de confiance bootstrap. Beaucoup d'études sur les objets connectés en santé se contentent d'une validation aléatoire qui gonfle les résultats. Ici, l'AUC de 0,72 est modeste, mais elle est honnête.
Ensuite parce qu'il documente, chiffres à l'appui, ce que valent les modèles de fondation en régime de rareté extrême. Quinze enfants, quelques heures de données, et pourtant un signal exploitable, précisément parce que l'on a emprunté des oreilles déjà éduquées. Le résultat « figé fait presque aussi bien qu'affiné » est une leçon utile pour quiconque travaille sur des données médicales rares : commencez par des embeddings gelés avant d'investir dans l'affinage.
Enfin parce qu'il déjoue une attente. Le récit dominant veut que la physiologie invisible soit la clé de la détection précoce. Ce papier montre que, dans ce cadre expérimental, c'est la voix qui parle le plus fort, et que la montre seule est proche du hasard. Cela ne clôt pas le débat, mais cela recadre où mettre l'effort d'ingénierie.
Les bémols, et ils sont nombreux
Les auteurs ne les cachent pas, et il faut les prendre au sérieux.
- Quinze participants, d'âges et de profils très hétérogènes. Les auteurs estiment que la performance est bornée par la taille de la cohorte plus que par le modèle. Aucune corrélation nette n'apparaît avec l'âge, le sexe ou le nombre d'événements, mais avec si peu d'enfants, l'absence de corrélation ne prouve pas grand-chose.
- L'onset annoté n'est pas le vrai début. Toute la partie « détection précoce » repose sur une frontière floue entre agitation réelle mais invisible et simple ressemblance temporelle entre fenêtres voisines.
- Une AUC de 0,72 n'est pas un système d'alerte. Pour un usage réel, il faudrait choisir un seuil, et à ce niveau on aura soit beaucoup de fausses alertes, soit beaucoup de crises manquées. L'analyse des erreurs distingue d'ailleurs deux profils : des enfants où le modèle sur-alerte, réparable par calibration, et des enfants où les distributions se chevauchent presque entièrement, ce qui signale un signal non capté.
- La dominance de l'audio est aussi une faiblesse. Les signes faciaux, posturaux ou de repli échappent aux centrales inertielles du haut du corps comme au micro. Et un micro-cravate en continu pose des questions de vie privée que le laboratoire n'a pas à résoudre, mais qu'un déploiement à la maison ou à l'école devra affronter.
- Le dispositif reste encombrant. Gilet à cinq capteurs, boîtier physiologique, micro : c'est acceptable en séance de thérapie, beaucoup moins dans un couloir d'école. Or la configuration légère, la montre, ne fonctionne pas.
- Le cadre est celui d'une agitation légère, provoquée en clinique. Par choix éthique, les sessions visaient une agitation non dangereuse, sous supervision, avec retour immédiat au renforcement. Ce n'est pas la crise réelle du quotidien.
Et maintenant ?
Les auteurs annoncent plusieurs suites : élargir la cohorte sans gommer la variabilité entre enfants, tester un étiquetage continu de l'intensité plutôt qu'un simple instant d'apparition, explorer d'autres modalités pour les signes diffus, comme la vidéo haute résolution ou la thermographie, et confronter les fenêtres pré-onset signalées à un regard clinique prospectif. Leur horizon à long terme est ambitieux : passer de l'aide au clinicien à l'aide à la personne elle-même, pour qu'un jeune puisse apprendre à reconnaître sa propre montée en tension et à la réguler.
Ce que l'on surveillera, pour notre part, c'est le passage à l'échelle et le passage au réel. Une cohorte dix fois plus grande confirmera-t-elle que le tronc partagé tient la route ? Un capteur audio discret, traité localement pour ne jamais stocker la voix, peut-il conserver le signal tout en respectant l'intimité des familles ? Et surtout, ces trente secondes gagnées se traduisent-elles, dans une salle de classe, par une crise évitée ? Le papier ne répond pas encore à ces questions, mais il les pose avec les bons garde-fous. Et il rappelle qu'en matière d'IA au service des personnes vulnérables, la technologie la plus utile n'est pas toujours celle que l'on attendait.
Référence : Nibraas Khan, Abigale Plunk, John Staubitz, Ingrid Shragge, Jordan Brooks, Suzanne Wright, Alec Brewer, James Dieffenderfer, Alper Bozkurt, Amy Weitlauf et Nilanjan Sarkar, Detecting Agitation Before Behavioral Escalation in Autistic Youth Through Multimodal Wearable Sensing, arXiv:2609.24791, déposé le 21 septembre 2026. https://arxiv.org/abs/2609.24791