lab
La data science, papier par papier.
Des papiers arXiv choisis et rendus accessibles — comprendre ce qui peut changer la donne, pour la société comme pour la tech.
lit les papiers · déchiffre · partage
§ derniers articles
Tous les articles →
2026-10-08·15 min de lecture
Budget de raisonnement et biais cognitifs
Une étude dose-réponse sur 12 350 appels API montre que les modèles de raisonnement (Claude, GPT-5.1, DeepSeek-R1, Qwen3) ne sont pas moins sujets aux biais cognitifs que leurs jumeaux sans thinking, que quatre biais sur six vont à l'envers des humains, et qu'une consigne d'une ligne bat des milliers de tokens de délibération.
2026-10-07·13 min de lecture
Distraction clinique des LLM
Une étude arXiv montre que les IA de documentation médicale glissent les bavardages de consultation dans 35 % des notes et laissent fuiter la voix d'une autre consultation dans près de la moitié des transcriptions. Et la cause semble logée au cœur même de leur raisonnement clinique.
2026-10-06·15 min de lecture
VeriSpec : quand une IA relit la « constitution » de ChatGPT et y trouve cinq contradictions
Le Model Spec d'OpenAI, le texte qui dicte le comportement de ChatGPT, contient des règles impossibles à respecter en même temps. VeriSpec, un auditeur à base de LLM, en a débusqué cinq, pour environ 11 $ pièce.
2026-09-30·13 min de lecture
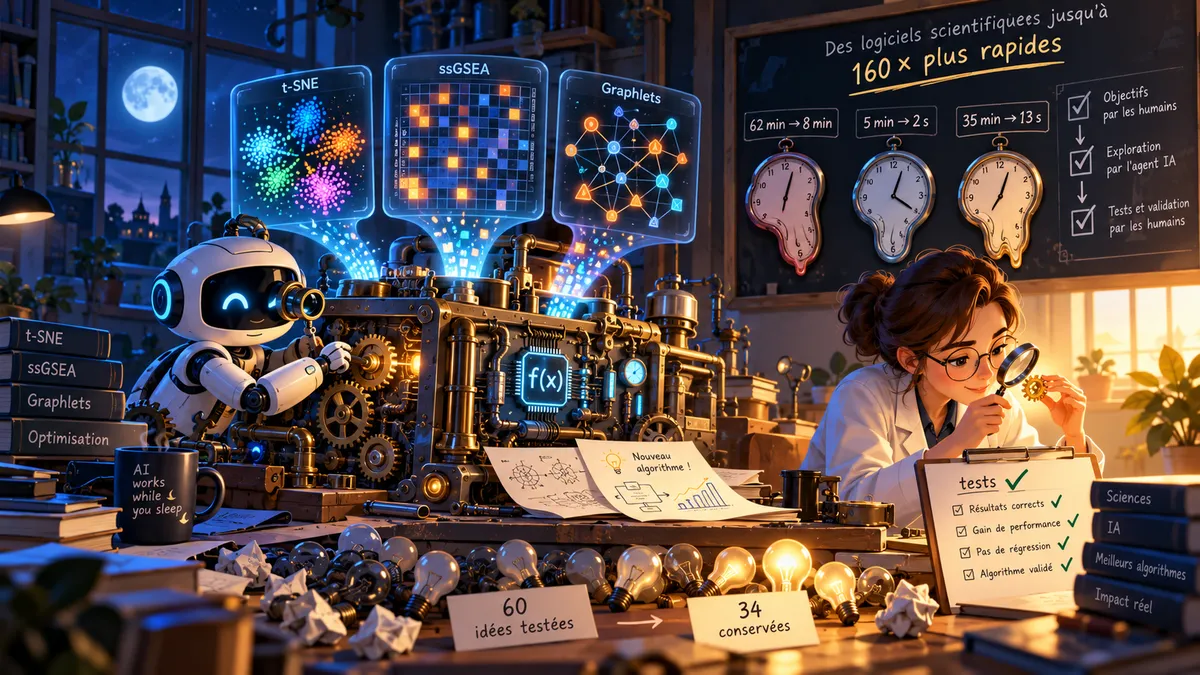
Optimisation logicielle par agent IA
Un agent IA (Claude Opus 5 via Claude Code) a accéléré openTSNE, ssGSEA et le comptage de graphlets. Il a obtenu jusqu'à 160 fois plus de vitesse et a même trouvé un nouvel algorithme. Voici ce que le papier arXiv 2609.37849 change au métier d'optimiseur.
2026-09-29·13 min de lecture
Fabriquer une fausse info coûte jusqu'à 169 fois moins cher que de la vérifier
Avec VEX-Bench, des chercheurs chiffrent l'asymétrie entre produire de la désinformation avec un LLM et la vérifier : de 3 à 169 fois moins cher. Les contenus les plus retors accaparent en prime le temps des fact-checkers.