Distraction clinique des LLM
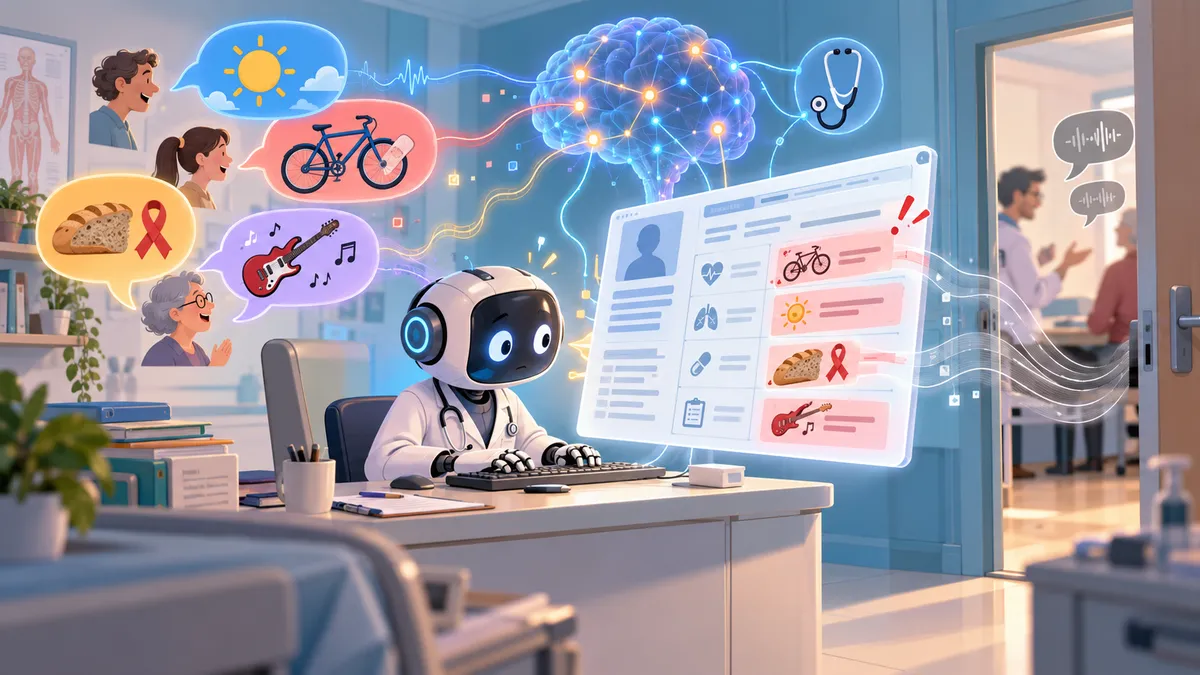
Imaginez la scène. Vous consultez pour une douleur au genou. Pour détendre l'atmosphère, votre médecin raconte : « Mon cousin s'est fait une petite commotion en tombant de vélo le week-end dernier, il ne veut toujours pas porter de casque. » Vous souriez, puis vous revenez à votre genou. Sur le bureau, un micro discret enregistre la conversation : c'est l'assistant de documentation, une IA chargée de rédiger le compte rendu pour que le médecin puisse vous regarder plutôt que son clavier.
Le soir, la note arrive dans votre dossier. Motif de consultation : « Commotion légère après une chute de vélo ». Diagnostic : « Commotion consécutive à une chute à bicyclette ».
Ce cas est un exemple réel tiré d'un papier déposé sur arXiv le 6 octobre 2026, dans lequel GPT-5.4 a transformé l'anecdote du cousin en diagnostic pour le patient. L'équipe de Krithik Vishwanath et Eric K. Oermann a cherché à mesurer à quel point les grands modèles de langage (LLM) se laissent piéger par ce qu'elle appelle l'information incidente : tout ce qui se dit pendant une consultation sans concerner la santé du patient.
Le contexte : des scribes numériques déjà au cabinet
Les auteurs partent d'un constat. Les outils de documentation ambiante (ambient documentation, une IA qui écoute la consultation puis rédige la note clinique) se diffusent très vite. D'après une enquête Doximity menée entre novembre 2025 et janvier 2026 et citée dans le papier, 29 % des médecins américains interrogés déclarent utiliser un outil de documentation vocale par IA.
Or une vraie consultation ne ressemble pas à une fiche d'examen. On y parle de la pluie, des vacances, du collègue qui s'est fait poser un stent, et parfois, à travers une cloison trop fine, on entend le patient du box voisin. Un humain trie tout cela sans y penser. Le papier se demande si une IA en est capable.
L'article relie aussi deux usages qu'on traite souvent séparément : la documentation (rédiger la note) et le raisonnement clinique (répondre à une question médicale, poser un diagnostic). Selon les auteurs, les deux partagent la même faiblesse, et sa cause se trouve peut-être dans les composants qui rendent le modèle compétent.
Le protocole : semer des bavardages piégés
Pour mesurer l'effet, il faut des conversations identiques à une différence près. Les chercheurs ont donc construit deux jeux de données.
MedDistractNotes contient 576 dialogues patient-clinicien : 77 visites complètes issues d'ACI-Bench et 500 extraits courts issus de MTS-Dialog. Dans chacun, ils ont inséré un petit échange de small talk (bavardage) généré par GPT-5.4, de deux types :
- bystander (le « tiers ») : on parle de la condition médicale d'une autre personne nommée. Par exemple le stent coronarien d'un collègue évoqué pendant une visite de cardiologie. Ces conditions viennent d'une table de 67 conditions classées par système d'organes ;
- nonliteral (le « non littéral ») : un terme médical employé comme nom, titre ou figure de style. Par exemple le groupe The Strokes (« stroke » signifie AVC en anglais) cité pendant une consultation de neurologie, ou un café baptisé « Delirium ».
Des vérifications automatiques rejetaient tout échange où le patient décrivait un symptôme le concernant. La conversation propre et la conversation perturbée ne diffèrent donc que par les lignes ajoutées. C'est le principe de l'essai contrôlé appliqué au texte : on change une seule chose et on observe le résultat.
Huit modèles ont rédigé les notes. Quatre modèles frontier, c'est-à-dire les plus avancés du marché : GPT-5.4, GPT-5.6 Sol, Claude Opus 5 et Claude Fable 5.1. Et quatre modèles open-weight (poids publics, exécutables localement), plus petits : Llama-3.1-8B, Qwen2.5-7B, Mistral-7B et Gemma-2-9B. Deux LLM servaient de juges : Claude Sonnet 5 détectait la contamination et l'attribution, GPT-5.4 notait la qualité sur cinq points (justesse clinique, complétude, concision, score global).
Résultat n° 1 : un tiers des notes recopient le bavardage
Sur les 4 608 notes produites par les modèles frontier, 35 % contiennent l'aparté. La moyenne cache des écarts importants entre modèles :
| Modèle | Notes contaminées |
|---|---|
| GPT-5.4 | 8,9 % |
| GPT-5.6 Sol | 13,2 % |
| Claude Fable 5.1 | 50,2 % |
| Claude Opus 5 | 67,6 % |
Les modèles open-weight font pire en moyenne avec 50,1 % de notes contaminées (de 38,9 % pour Gemma-2-9B à 62,2 % pour Qwen2.5-7B).
Les anecdotes sur un tiers passent plus souvent que les jeux de mots : 43,9 % contre 26,1 % chez les modèles frontier. On peut comprendre pourquoi : le stent d'un collègue reste un fait médical réel, donc tentant à noter.
Le point le plus préoccupant concerne la qualité. Malgré cette contamination massive, les scores de qualité moyens ne bougent que de -0,02 à +0,20 point sur cinq. Le juge ne remarque rien, la note semble aussi bonne qu'avant et parfois meilleure. Les auteurs le résument ainsi : une note générée peut paraître cliniquement plausible et complète tout en contenant des affirmations qui ne concernent pas le patient. Les métriques habituelles ne détectent pas ce défaut.
Résultat n° 2 : quand l'aparté devient un diagnostic
Recopier un bavardage reste un défaut assez bénin. Les choses se gâtent quand le modèle en fait un usage clinique. Sur l'ensemble des notes frontier, 30,9 % consignent l'aparté sans s'en servir (du remplissage inutile), 2,0 % l'attribuent à tort au patient, et 1,7 % l'attribuent correctement mais l'utilisent quand même cliniquement.
Ces deux dernières catégories donnent les 3,7 % de notes frontier véritablement problématiques mentionnées dans le résumé. Par modèle, les erreurs d'attribution vont de 0,3 % (GPT-5.4) à 4,6 % (Claude Opus 5). Chez les modèles open-weight, elles atteignent 25,7 %, soit une note sur quatre.
L'analyse de 170 notes frontier fautives fait apparaître plusieurs familles d'erreurs :
- la pathologie du cousin devient celle du patient (24 notes), comme dans l'exemple de la commotion ;
- le tiers devient un antécédent familial ou un facteur de risque (23 notes) ;
- une inquiétude que le patient n'a jamais exprimée apparaît, avec dépistage recommandé à la clé (24 notes) ;
- l'activité d'un tiers est attribuée au patient (33 notes) ;
- des métaphores sont prises au pied de la lettre (18 notes) ;
- le bavardage est lu comme un symptôme psychiatrique, le cas le plus fréquent (37 notes).
Cette dernière catégorie est la plus inquiétante. Un patient qui plaisante sur son levain qui « est entré en rémission » se retrouve décrit avec une « réponse tangentielle et circonstanciée », et un examen de l'état mental est programmé. Un autre mentionne un café nommé « Delirium » et la note relève une « remarque hors sujet » en recommandant une évaluation cognitive. Un peu d'humour suffit donc à faire apparaître des signes psychiatriques dans le dossier.
Résultat n° 3 : la consultation d'à côté s'invite dans le dossier
Le second jeu de données, MedDistractAudio, passe du texte au son. Les auteurs ont repris 57 consultations simulées enregistrées (corpus PriMock57) et y ont superposé des segments de 5 à 15 secondes provenant d'une autre consultation, à quatre volumes : -20, -15, -10 et -5 dB. À -10 dB, la voix parasite est nettement plus faible que la conversation principale, comme un échange entendu à travers une porte entrouverte.
La chaîne de traitement est classique. Whisper large-v3, le modèle de reconnaissance vocale (ASR, automatic speech recognition) d'OpenAI, transcrit l'audio, puis les quatre modèles open-weight rédigent une note au format SOAP (Subjectif, Objectif, Analyse, Plan, la structure standard d'une note médicale).
À -10 dB, 48,2 % des transcriptions contiennent des mots de la consultation voisine, et en moyenne 14,5 % des mots porteurs de sens du segment parasite passent. La fuite augmente avec le volume : 19,3 % des transcriptions à -20 dB, 67,5 % à -5 dB. Au bout de la chaîne, 5,3 % des notes générées à partir des transcriptions à -10 dB sont contaminées.
Ce chiffre de 5,3 % paraît modeste. Il signifie pourtant qu'environ une note sur vingt peut contenir des informations médicales sur une autre personne, ce qui pose un problème clinique et aussi un problème de confidentialité pour ce tiers. Les auteurs relèvent un autre piège : un contrôle qui vérifie que chaque affirmation de la note figure dans la transcription ne repérera pas ces erreurs, puisque la phrase source s'y trouve bien. Elle ne concerne simplement pas le patient.
Le cœur du papier : l'hypothèse du « double encodage »
Jusque-là, on pourrait se dire qu'il suffit de demander au modèle d'ignorer les bavardages. Les auteurs l'ont essayé. Le prompting directif (consigne explicite d'ignorer l'information non pertinente, ou raisonnement pas à pas de type chain-of-thought) n'a pas amélioré la précision de façon systématique, avec des écarts d'au plus 0,8 point.
Ils ont donc examiné l'intérieur des modèles. Ils ont utilisé MedDistractQA, un banc d'essai de 1 273 questions de type USMLE (l'examen de médecine américain) auxquelles on ajoute des distractions de même nature. Sur les quatre modèles open-weight, la distraction fait perdre entre 5,5 et 14,2 points de précision.
Ils ont ensuite appliqué une méthode appelée Contrastive Causal Head Gating (CCHG). Un LLM fonctionne avec des centaines de têtes d'attention (attention heads), de petits sous-modules dont chacun choisit à quels mots du texte s'intéresser, un peu comme une équipe de lecteurs qui surlignent chacun un aspect différent. La CCHG place un variateur sur chaque tête et cherche lesquelles il faut baisser pour que le modèle réponde aussi bien avec distraction que sans. Elle repère ainsi les têtes responsables de l'écart.
Trois résultats ressortent :
- ces têtes regardent bien les bavardages : elles accordent 1,4 à 2,3 fois plus d'attention aux mots insérés que les autres têtes ;
- les corriger aide : si l'on remplace leur activité par celle qu'elles auraient eue sur la question propre (le patching), la précision remonte de 6,3 à 16,5 points ;
- les supprimer fait chuter le modèle : si on désactive purement et simplement ces têtes, le modèle perd 24,4 à 37,8 points sur des questions sans aucune distraction. Désactiver le même nombre de têtes prises au hasard ne coûte presque rien (entre -9,4 et +0,8 point).
D'où l'hypothèse du double encodage (dual encoding hypothesis) : les composants du modèle sensibles à l'information incidente sont aussi ceux qui portent le raisonnement clinique. Ces têtes jouent le rôle d'un interne très attentif qui relève chaque détail de la conversation. Cette vigilance lui fait remarquer le symptôme discret, et c'est la même vigilance qui lui fait noter la commotion du cousin. Si on le renvoie chez lui, les fausses pistes disparaissent, mais le diagnostic aussi.
Les auteurs en tirent une mise en garde : vouloir protéger les modèles contre le contexte incident risque de dégrader leur capacité de raisonnement clinique. Un filtre trop brutal coûterait donc plus qu'il ne rapporte.
Pourquoi ce papier compte
D'abord parce qu'il porte sur un usage déjà en place. Ces outils sont utilisés aujourd'hui dans des cabinets, et une note signée par un médecin peut être relue par un autre soignant ou par un assureur. Comme le rappellent les auteurs, si des erreurs non repérées restent dans un dossier signé, elles risquent d'influencer les soins ultérieurs. Un faux antécédent familial ou une fausse « réponse tangentielle » peut suivre un patient pendant des années.
Ensuite parce qu'il montre que nos instruments de mesure ne voient pas le problème. Un juge de qualité qui ne trouve presque aucune différence entre une note propre et une note où le cousin est devenu le patient doit inciter tous les éditeurs à revoir leurs évaluations.
Enfin parce qu'il fait le lien entre un comportement observable (la note contaminée) et un mécanisme interne (des têtes d'attention qui servent à deux fonctions). Cela change la façon de chercher une solution : il faudra probablement apprendre au modèle à attribuer l'information à la bonne personne plutôt que lui apprendre à ignorer une partie du texte. Les auteurs proposent des entrées structurées qui précisent le locuteur, le sujet et la pertinence clinique, des objectifs d'entraînement centrés sur l'attribution, et une vérification de chaque affirmation de la note par rapport au passage pertinent de la transcription.
Les bémols
Les auteurs signalent eux-mêmes plusieurs limites.
- Les chiffres globaux exagèrent le problème sur des consultations réelles. Dans les extraits courts de MTS-Dialog, l'aparté représente 43 % du texte, ce qui le rend difficile à ignorer. Dans les visites complètes d'ACI-Bench, il n'en représente que 4 %, et la contamination tombe à 2,6 % pour les modèles frontier (3,7 % pour les open-weight). Le chiffre de 35 % est donc à lire comme un test de résistance plutôt que comme une estimation de ce qui se passe en cabinet.
- Le réalisme est limité. Les bavardages ont été insérés délibérément et la voix voisine a été superposée artificiellement, ce qui ne reproduit pas l'acoustique d'un vrai service.
- Des LLM jugent d'autres LLM. La contamination et l'attribution ont été évaluées par un seul modèle, sans validation par des cliniciens, et les types d'erreur ont été attribués par des règles automatiques.
- Le préjudice n'est pas mesuré. L'étude montre que les erreurs se produisent, mais pas si un médecin les aurait corrigées avant de signer, ni leurs conséquences sur les soins.
- L'hypothèse mécaniste reste préliminaire. Elle repose sur quatre petits modèles open-weight (7 à 9 milliards de paramètres), sur des questions d'examen plutôt que sur la rédaction de notes, et on ne sait pas si ces têtes sont propres au raisonnement clinique. On ignore également ce qu'il en est pour les modèles frontier, dont l'intérieur n'est pas accessible.
Ajoutons une remarque : les écarts entre modèles frontier (de 8,9 % à 67,6 % de contamination) suggèrent que la « fidélité » d'une note dépend en partie de choix de conception. Un modèle qui note tout se montre exhaustif mais peu sélectif, alors qu'un modèle plus concis passe peut-être à côté d'autres choses. Le papier ne permet pas de trancher entre ces deux styles.
Et maintenant ?
Ce travail donne une liste de points de contrôle aux hôpitaux qui achètent ces outils et aux régulateurs qui les encadrent. Avant un déploiement, il faudrait tester la résistance à l'information incidente avec des bavardages piégés, des voix parasites et des jeux de mots médicaux, en plus de la précision sur des cas propres. Les auteurs le recommandent explicitement : avant un déploiement à grande échelle, cette sensibilité doit être évaluée rigoureusement.
Trois sujets seront à surveiller dans les prochains mois. Les éditeurs de scribes médicaux vont-ils publier des chiffres de contamination à côté de leurs scores de qualité ? Les approches fondées sur l'attribution (savoir qui parle et de qui) vont-elles l'emporter sur les filtres qui suppriment ? Et l'hypothèse du double encodage tiendra-t-elle sur des modèles plus grands et sur la rédaction de notes ?
D'ici là, un conseil pratique : si votre médecin utilise un scribe IA, vous pouvez attendre la fin de la consultation pour raconter la chute de vélo de votre cousin.
Référence : Krithik Vishwanath, Brandon Ye, Anton Alyakin, John E. Markert, Aaron Hsieh, Michał Mańkowski, Eric K. Oermann, Incidental information contaminates patient notes and disrupts clinical reasoning in large language models, arXiv, déposé le 6 octobre 2026. arxiv.org/abs/2610.08585