journal
Blog
2026-10-08·15 min de lecture
Budget de raisonnement et biais cognitifs
Une étude dose-réponse sur 12 350 appels API montre que les modèles de raisonnement (Claude, GPT-5.1, DeepSeek-R1, Qwen3) ne sont pas moins sujets aux biais cognitifs que leurs jumeaux sans thinking, que quatre biais sur six vont à l'envers des humains, et qu'une consigne d'une ligne bat des milliers de tokens de délibération.
2026-10-07·13 min de lecture
Distraction clinique des LLM
Une étude arXiv montre que les IA de documentation médicale glissent les bavardages de consultation dans 35 % des notes et laissent fuiter la voix d'une autre consultation dans près de la moitié des transcriptions. Et la cause semble logée au cœur même de leur raisonnement clinique.
2026-10-06·15 min de lecture
VeriSpec : quand une IA relit la « constitution » de ChatGPT et y trouve cinq contradictions
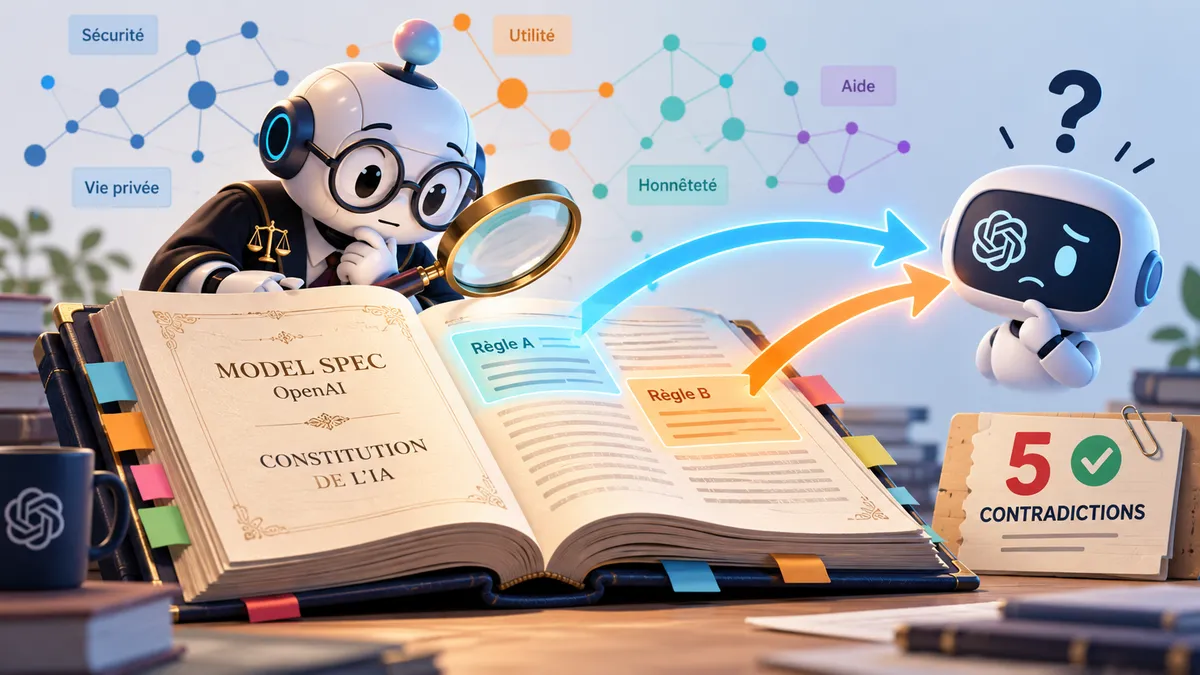
Le Model Spec d'OpenAI, le texte qui dicte le comportement de ChatGPT, contient des règles impossibles à respecter en même temps. VeriSpec, un auditeur à base de LLM, en a débusqué cinq, pour environ 11 $ pièce.
2026-09-30·13 min de lecture
Optimisation logicielle par agent IA
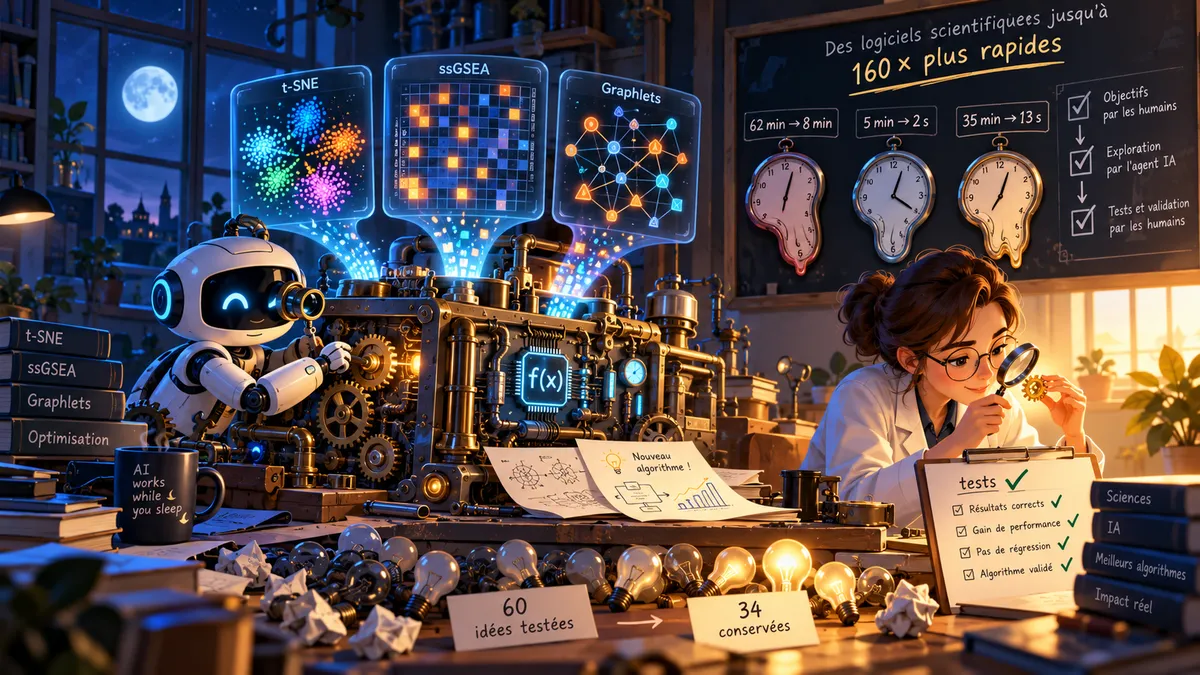
Un agent IA (Claude Opus 5 via Claude Code) a accéléré openTSNE, ssGSEA et le comptage de graphlets. Il a obtenu jusqu'à 160 fois plus de vitesse et a même trouvé un nouvel algorithme. Voici ce que le papier arXiv 2609.37849 change au métier d'optimiseur.
2026-09-29·13 min de lecture
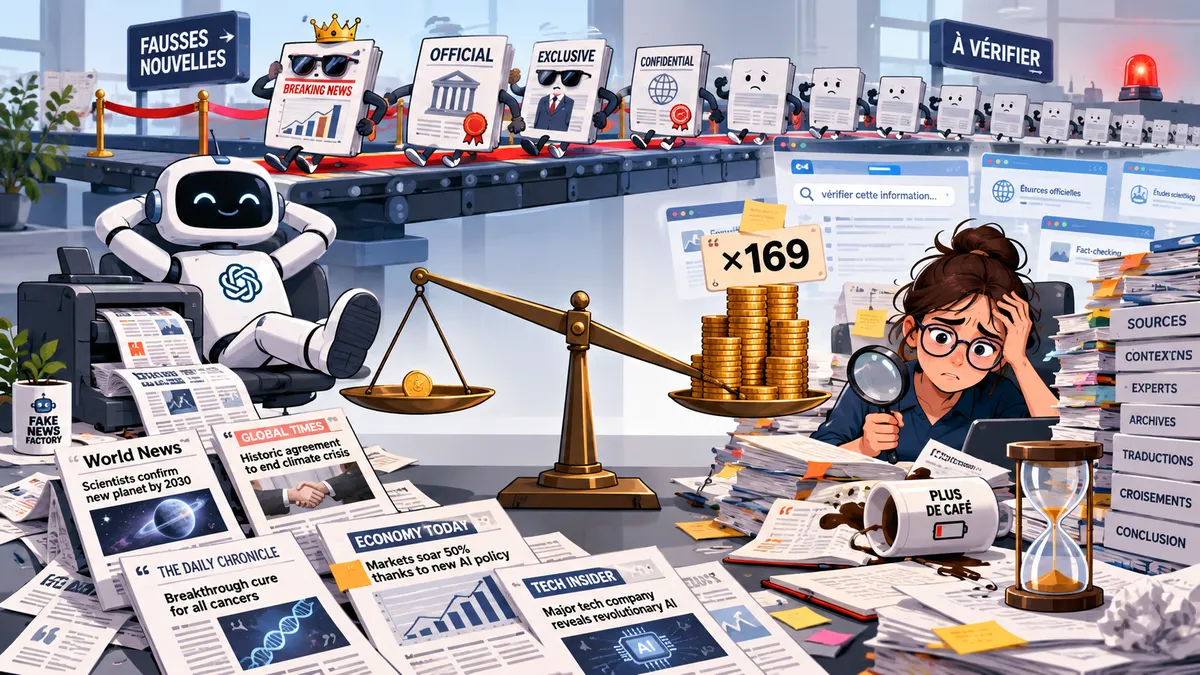
Fabriquer une fausse info coûte jusqu'à 169 fois moins cher que de la vérifier
Avec VEX-Bench, des chercheurs chiffrent l'asymétrie entre produire de la désinformation avec un LLM et la vérifier : de 3 à 169 fois moins cher. Les contenus les plus retors accaparent en prime le temps des fact-checkers.
2026-09-23·15 min de lecture
Déviation de la boussole des valeurs
Une étude préenregistrée sur 200 adultes montre qu'une brève conversation avec un LLM, sans recommandation ni valeur nommée, déplace temporairement les priorités morales vers l'auto-valorisation. Décryptage du protocole, des chiffres et des limites.
2026-09-22·12 min de lecture
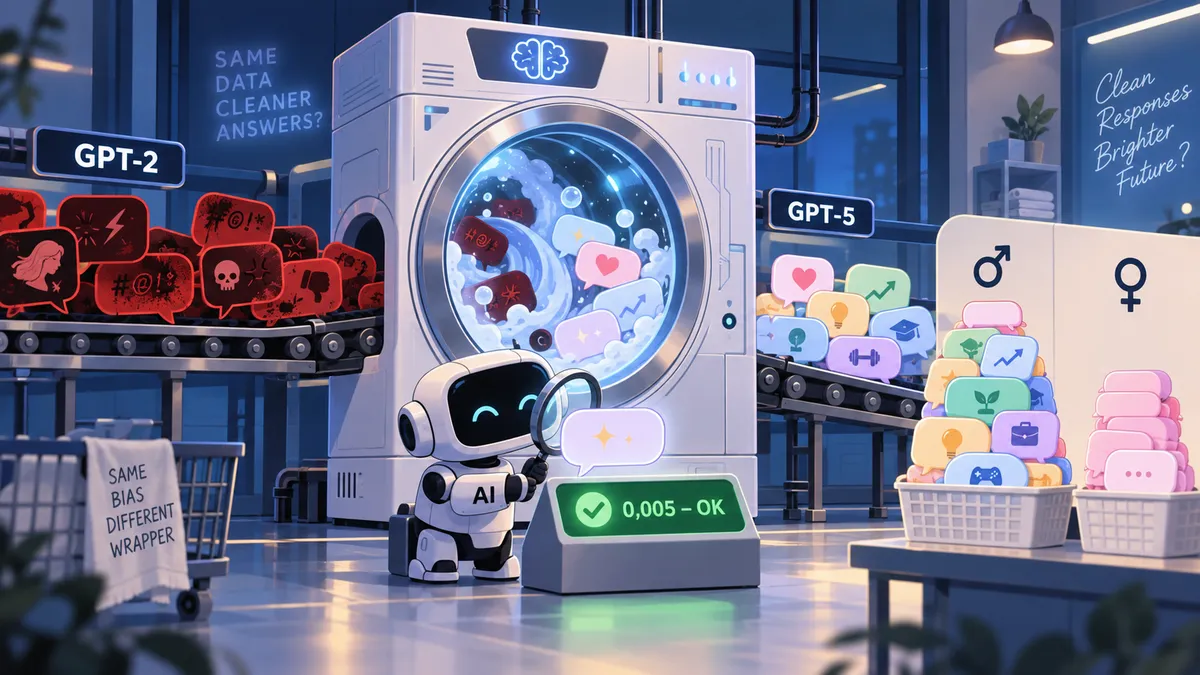
Harm laundering : de GPT-2 à GPT-5, le sexisme n'a pas disparu
Les scores de toxicité des modèles GPT baissent de génération en génération. Une étude portant sur 450 000 complétions montre que la discrimination de genre a surtout changé de forme et que les détecteurs automatiques ne la voient plus.
2026-09-20·12 min de lecture
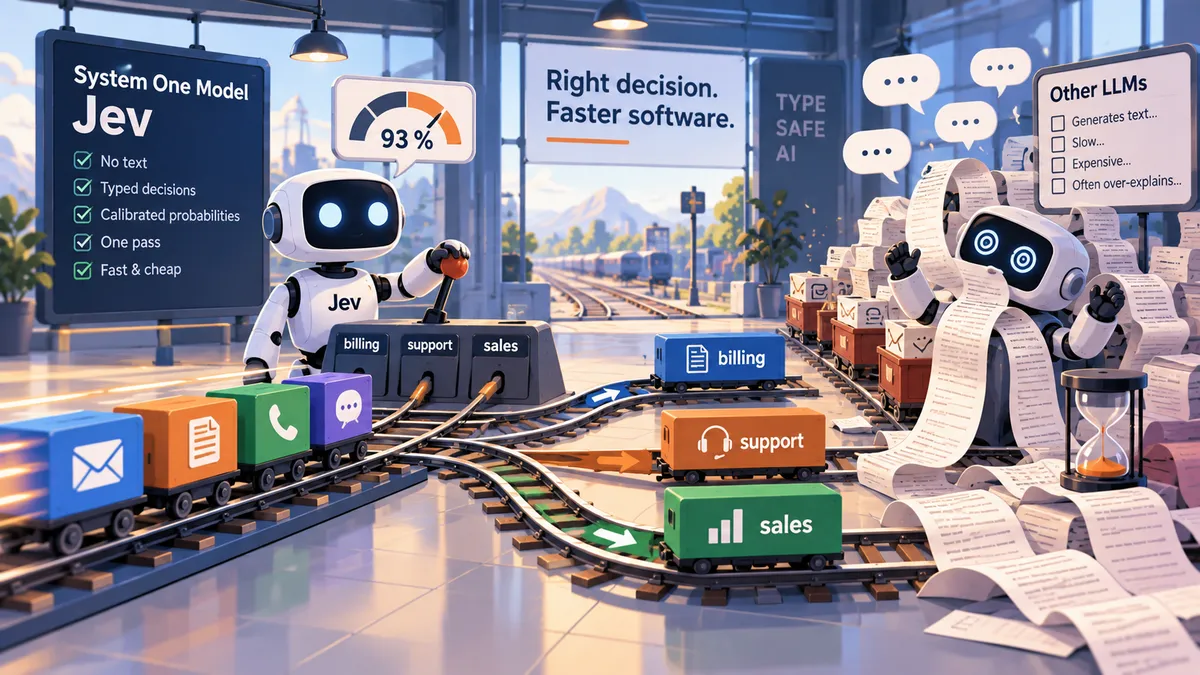
System One Model : Jev, l'IA qui ne parle pas
TypeSafe AI lance Jev, un modèle qui ne génère aucun texte : il rend des décisions typées avec des probabilités calibrées, en 100 ms et pour 0,042 $ le million de tokens. Décryptage d'une annonce sans papier arXiv, promesses et angles morts compris.
2026-09-18·12 min de lecture
Biais géopolitique multilingue des LLM
Un chercheur d'Oxford a interrogé GPT, Claude et Gemini sur la guerre en Ukraine dans 112 langues, soit 67 200 réponses. Selon la langue, l'équilibre des réponses suit les fractures géopolitiques mondiales : opinion publique, votes à l'ONU, aide à Kyiv.