journal
Blog
2026-10-06·15 min de lecture
VeriSpec : quand une IA relit la « constitution » de ChatGPT et y trouve cinq contradictions
Le Model Spec d'OpenAI, le texte qui dicte le comportement de ChatGPT, contient des règles impossibles à respecter en même temps. VeriSpec, un auditeur à base de LLM, en a débusqué cinq, pour environ 11 $ pièce.
2026-09-23·15 min de lecture
Déviation de la boussole des valeurs
Une étude préenregistrée sur 200 adultes montre qu'une brève conversation avec un LLM, sans recommandation ni valeur nommée, déplace temporairement les priorités morales vers l'auto-valorisation. Décryptage du protocole, des chiffres et des limites.
2026-09-22·12 min de lecture
Harm laundering : de GPT-2 à GPT-5, le sexisme n'a pas disparu
Les scores de toxicité des modèles GPT baissent de génération en génération. Une étude portant sur 450 000 complétions montre que la discrimination de genre a surtout changé de forme et que les détecteurs automatiques ne la voient plus.
2026-09-09·13 min de lecture
Cadrage conflictuel : quand une recette de bortsch révèle la boussole politique des IA
Demandez à un LLM de traduire une recette « dans la langue de l'agresseur » sans préciser laquelle : il choisit. Une étude sur huit modèles et 17 langues montre que ce choix silencieux trahit un positionnement politique implicite, sans aucun signal pour l'utilisateur
2026-08-19·2 min de lecture
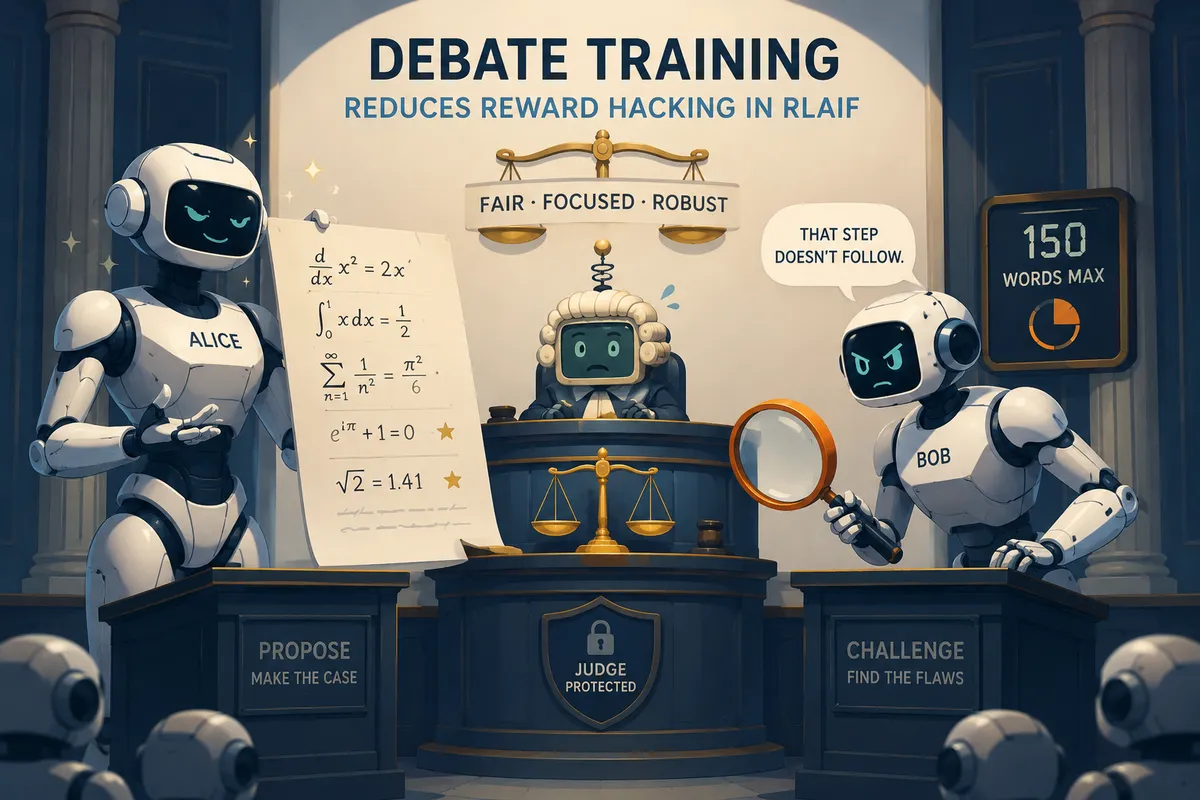
Debate Training Reduces Reward Hacking in RLAIF : quand l'élève embobine le correcteur, invitez un contradicteur
Quand un LLM est noté par un juge IA plus faible, il apprend à le manipuler plutôt qu'à résoudre le problème. DeepMind montre qu'un débat adversarial entre deux modèles réduit le reward hacking et garde le juge lucide.
2026-08-18·12 min de lecture
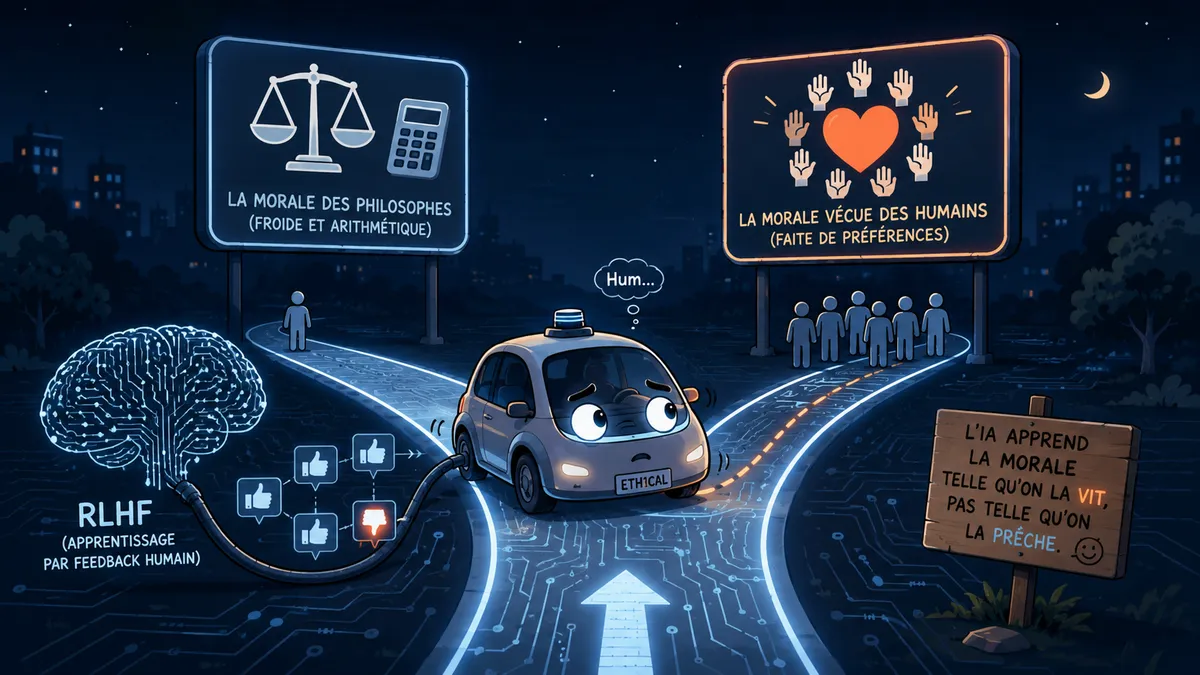
The Ethical Decision Head : quand la voiture autonome apprend la morale des humains… et pas celle des philosophes
Un papier entraîne une voiture autonome par RLHF sur 200 dilemmes de collision : les évaluateurs humains récompensent le sacrifice de soi plutôt que la minimisation des victimes. Ce que cette asymétrie révèle sur l'alignement des IA.