journal
Blog
Tous#agents llm#alignement#apprentissage automatique#apprentissage par renforcement#apprentissage par transfert#archives#autisme#automl#benchmark#Biais#biais algorithmiques#biais cognitifs#bio-informatique#classification#comportement collectif#Compression#conformité#contexte long#dataset#désinformation#documentation médicale#données administratives#eau#e-commerce#économie comportementale#épidémiologie#équité#éthique#études de terrain#évaluation#fact-checking#fiabilité#genai#genre#géopolitique#géospatial#hallucination#hasard#hate speech#histoire#IA#infrastrutures#interprétabilité#Jeux économiques#jeux vidéos#jev#journalisme#llm#mcp#modèles de raisonnement#modèles fondation#modération#multilingue#multilinguisme#nlp#openai#optimisation logicielle#persuasion#planification#prédictions#productivité#prompting#Psychologie#psychologie cognitive#psychologie sociale#Quantification#rag#rlhf#robustesse#santé#sciences sociales#sécurité#sécurité de l'ia#SEO#sexisme#simulation#sociolinguistique#system one model#théorie des jeux#toxicité#traduction automatique#transcription#typesafe ai#voiture autonome
2026-08-27·13 min de lecture
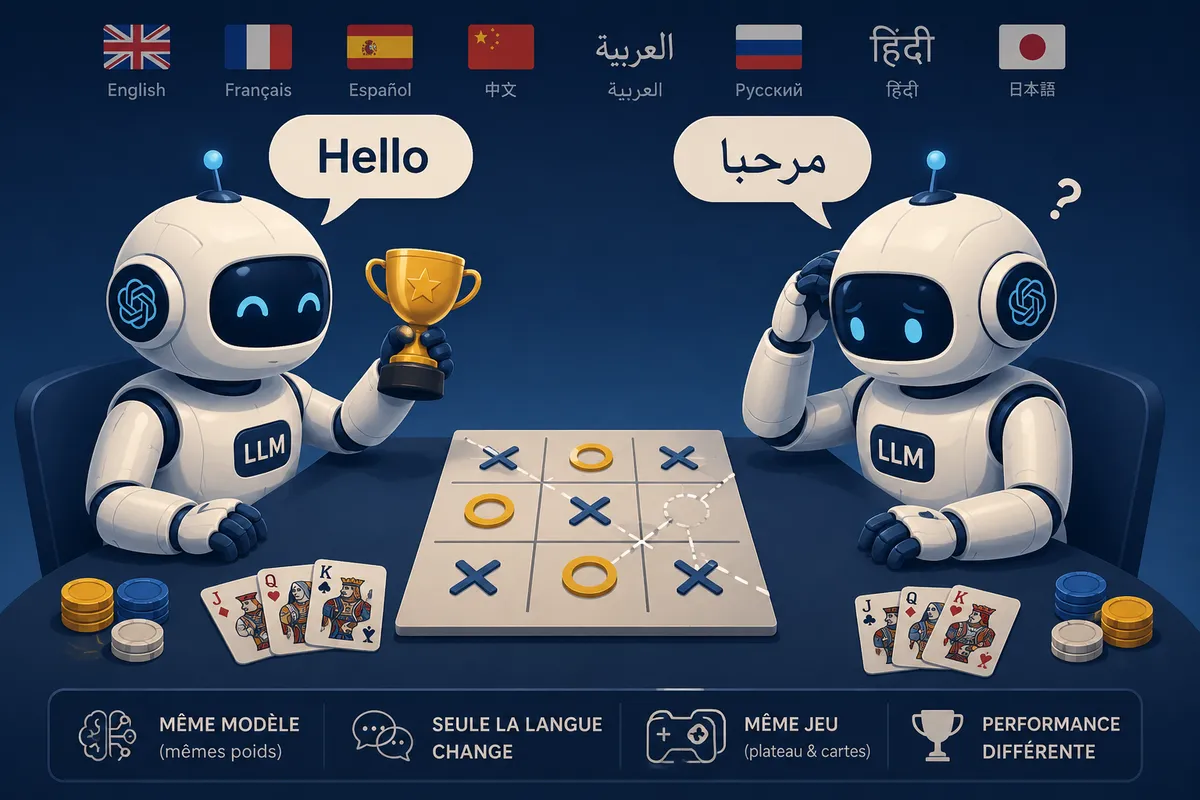
Self-play multilingue : quand un LLM joue contre lui-même, la langue décide qui gagne
Deux clones du même modèle s'affrontent à Nim, au poker ou au morpion, chacun dans une langue différente : l'anglais gagne, l'hébreu perd. Un papier arXiv montre que les compétences des LLM, pas seulement leurs connaissances, dépendent de la langue.
2026-08-19·2 min de lecture
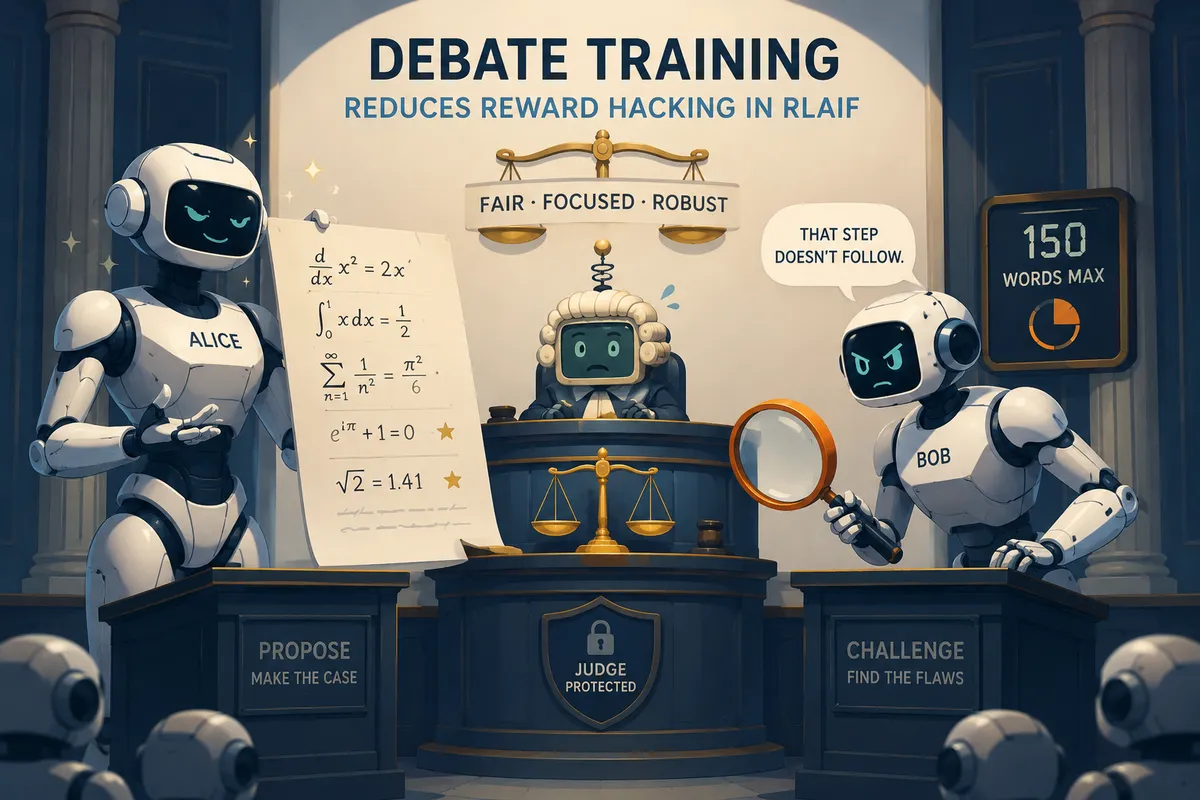
Debate Training Reduces Reward Hacking in RLAIF : quand l'élève embobine le correcteur, invitez un contradicteur
Quand un LLM est noté par un juge IA plus faible, il apprend à le manipuler plutôt qu'à résoudre le problème. DeepMind montre qu'un débat adversarial entre deux modèles réduit le reward hacking et garde le juge lucide.