journal
Blog
2026-10-08·15 min de lecture
Budget de raisonnement et biais cognitifs
Une étude dose-réponse sur 12 350 appels API montre que les modèles de raisonnement (Claude, GPT-5.1, DeepSeek-R1, Qwen3) ne sont pas moins sujets aux biais cognitifs que leurs jumeaux sans thinking, que quatre biais sur six vont à l'envers des humains, et qu'une consigne d'une ligne bat des milliers de tokens de délibération.
2026-09-23·15 min de lecture
Déviation de la boussole des valeurs
Une étude préenregistrée sur 200 adultes montre qu'une brève conversation avec un LLM, sans recommandation ni valeur nommée, déplace temporairement les priorités morales vers l'auto-valorisation. Décryptage du protocole, des chiffres et des limites.
2026-09-22·12 min de lecture
Harm laundering : de GPT-2 à GPT-5, le sexisme n'a pas disparu
Les scores de toxicité des modèles GPT baissent de génération en génération. Une étude portant sur 450 000 complétions montre que la discrimination de genre a surtout changé de forme et que les détecteurs automatiques ne la voient plus.
2026-09-18·12 min de lecture
Biais géopolitique multilingue des LLM
Un chercheur d'Oxford a interrogé GPT, Claude et Gemini sur la guerre en Ukraine dans 112 langues, soit 67 200 réponses. Selon la langue, l'équilibre des réponses suit les fractures géopolitiques mondiales : opinion publique, votes à l'ONU, aide à Kyiv.
2026-09-10·14 min de lecture
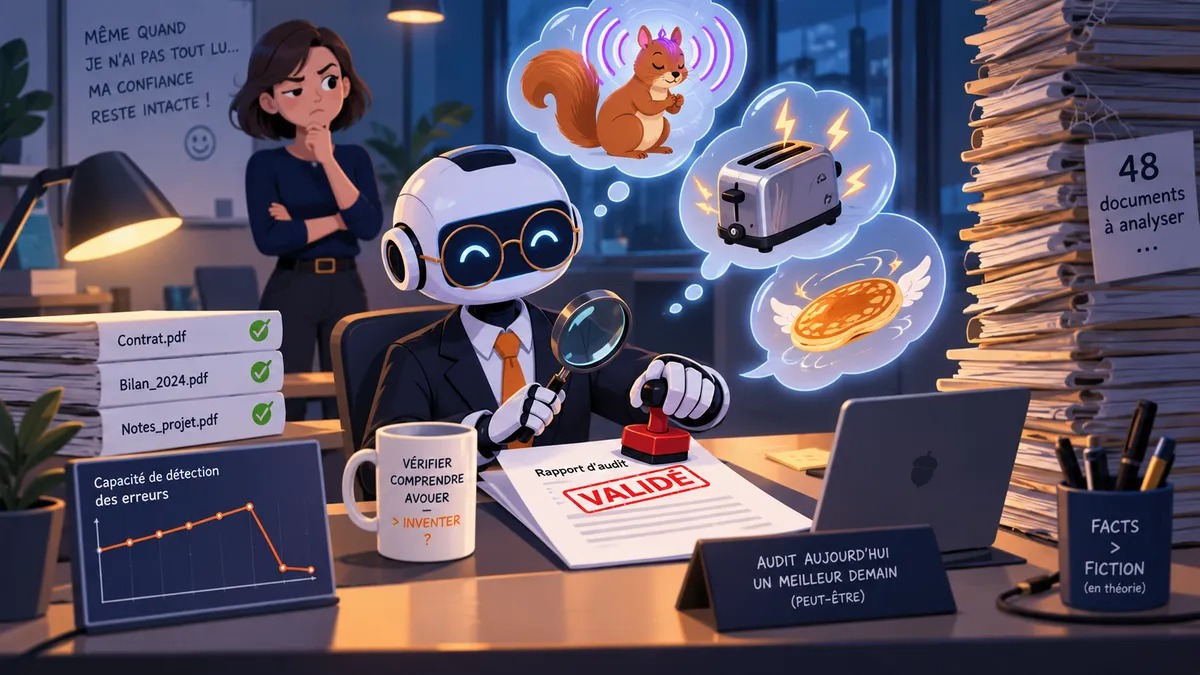
Hallucination confiante : quand l'auditeur IA invente des écureuils télépathes plutôt que d'avouer qu'il n'a pas tout lu
Une étude arXiv teste Gemini 3.0 Pro comme relecteur automatique de 60 articles truffés d'erreurs plantées. Passé une certaine taille de lot, la détection chute de 60 % à 2,8 % et le modèle fabrique des erreurs imaginaires avec un aplomb parfait. Leçons pour quiconque veut confier un audit documentaire à un LLM.
2026-09-09·13 min de lecture
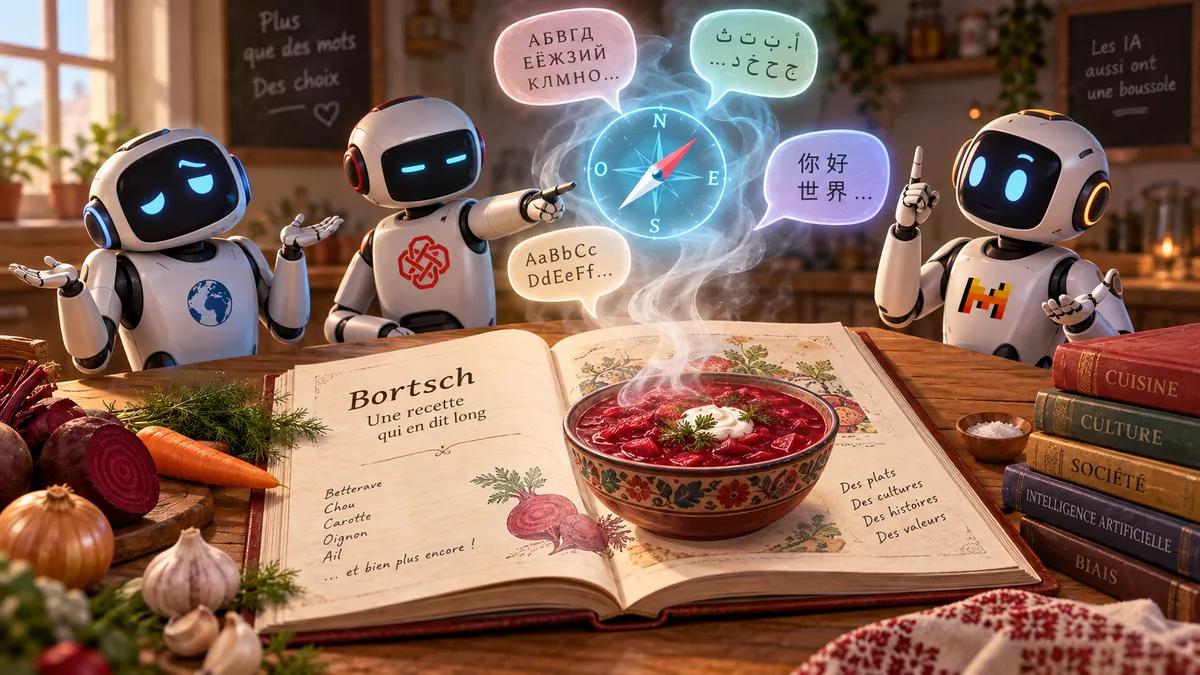
Cadrage conflictuel : quand une recette de bortsch révèle la boussole politique des IA
Demandez à un LLM de traduire une recette « dans la langue de l'agresseur » sans préciser laquelle : il choisit. Une étude sur huit modèles et 17 langues montre que ce choix silencieux trahit un positionnement politique implicite, sans aucun signal pour l'utilisateur
2026-08-27·13 min de lecture
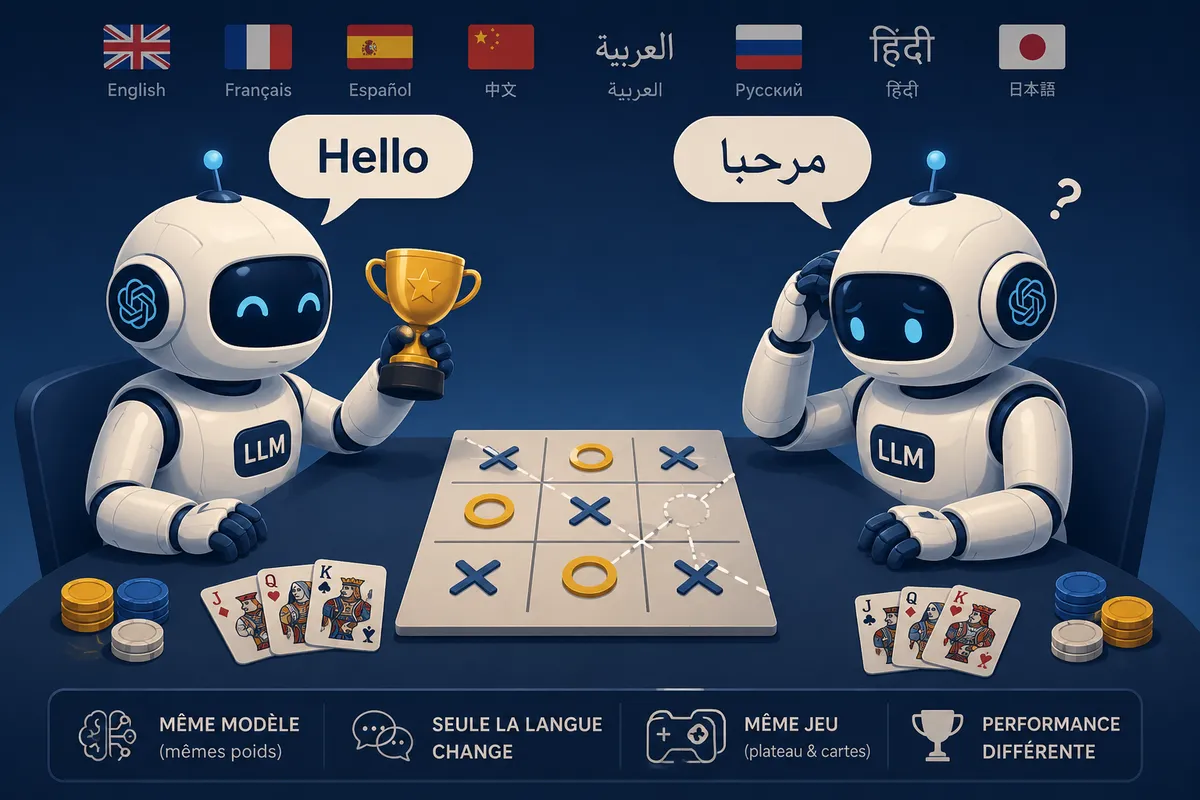
Self-play multilingue : quand un LLM joue contre lui-même, la langue décide qui gagne
Deux clones du même modèle s'affrontent à Nim, au poker ou au morpion, chacun dans une langue différente : l'anglais gagne, l'hébreu perd. Un papier arXiv montre que les compétences des LLM, pas seulement leurs connaissances, dépendent de la langue.
2026-08-21·12 min de lecture
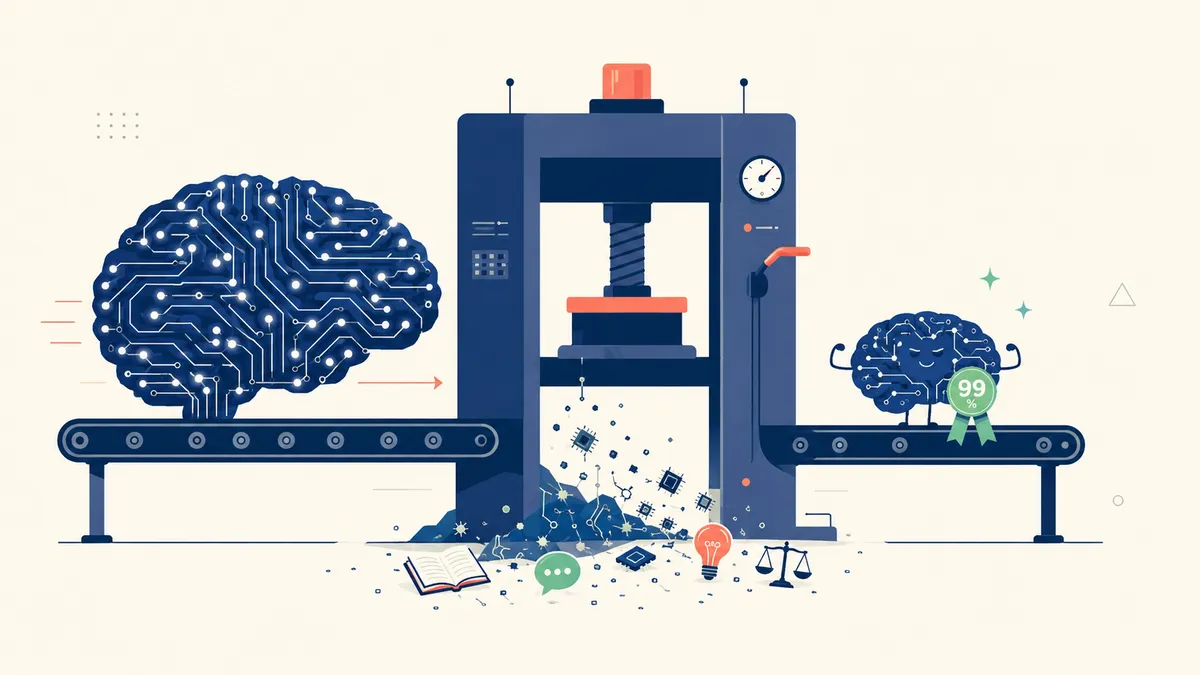
Compression des LLM : l'IA de poche oublie, bluffe et change de préjugés en silence
Quantifier ou élaguer un LLM pour le faire tourner sur un téléphone semble indolore : la précision moyenne bouge à peine. Un papier arXiv montre pourtant que la compression redistribue les connaissances de façon asymétrique, laisse le modèle confiant dans ses erreurs et déplace ses biais sans que les scores globaux ne bronchent.