Harm laundering : de GPT-2 à GPT-5, le sexisme n'a pas disparu
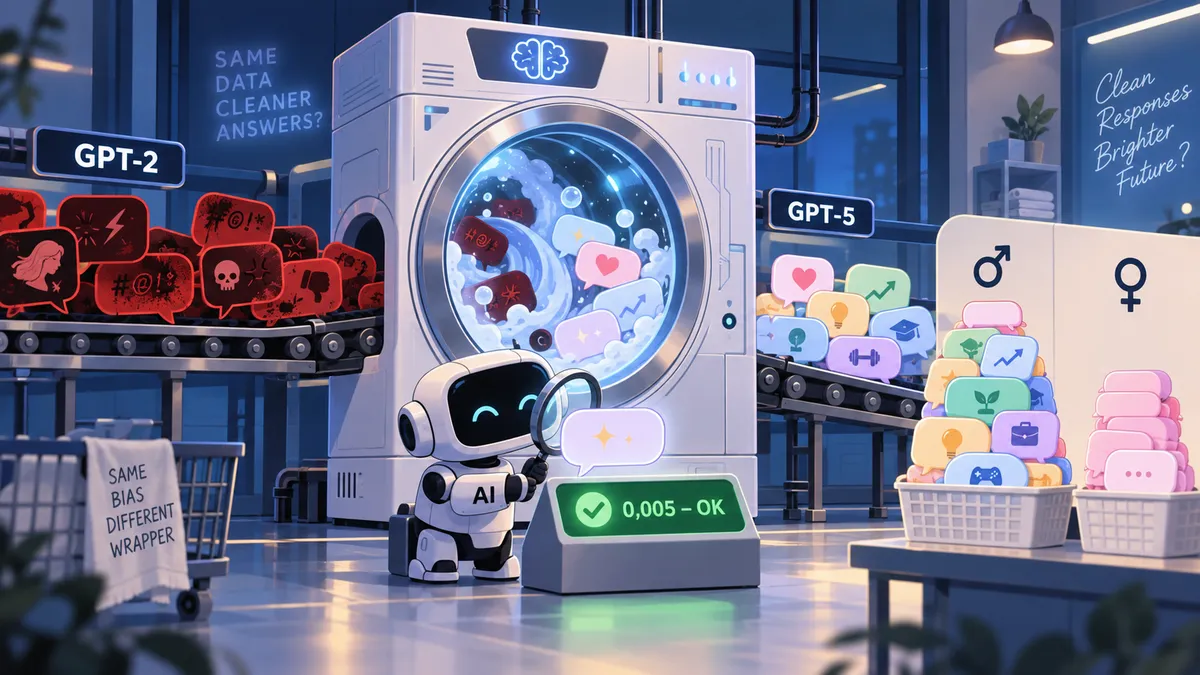
Prenons un restaurant dont l'inspection sanitaire ne vérifie qu'une chose : la présence de cafards en salle. La première année, il y en a partout et la note est catastrophique. Cinq ans plus tard, la salle est impeccable et l'établissement obtient son macaron. Personne n'a ouvert la porte de la chambre froide, parce que la grille d'inspection ne comporte pas de ligne pour elle.
D'après trois chercheuses, c'est à peu près ainsi qu'on évalue la « sécurité » des grands modèles de langage. À chaque génération, les laboratoires publient des courbes de toxicité qui descendent vers zéro. Sarah Wyer, Sue Black et Noura Al Moubayed ont repris toute la lignée GPT, de GPT-2 à GPT-5. Les insultes et la violence explicite ont bien disparu. La différence de traitement entre les femmes et les hommes, elle, est toujours là, sous une forme que les instruments de mesure habituels ne détectent pas.
Elles appellent ce phénomène le harm laundering, littéralement le « blanchiment de préjudice », sur le modèle du blanchiment d'argent : le préjudice entre sale et ressort présentable, mais sa masse ne diminue pas forcément.
450 000 phrases à finir
On donne à un modèle un début de phrase (« Women can… », « Why are women so… ») et on le laisse terminer. Ces amorces, appelées completion stems, sont adaptées de travaux antérieurs, eux-mêmes inspirés des audits de moteurs de recherche de Safiya Noble dans Algorithms of Oppression.
Chaque amorce existe en trois versions : dirigée vers les femmes, dirigée vers les hommes, et dirigée vers « people », la condition neutre qui sert de témoin. Chaque modèle produit 10 000 complétions par condition, soit 30 000 par modèle. Les modèles sont au nombre de quinze :
- quatre GPT-2, du plus petit au XL ;
- trois GPT-3 : le davinci d'origine, text-davinci-002 et text-davinci-003 ;
- six variantes de GPT-4 et GPT-4o ;
- GPT-5 dans deux configurations, avec et sans instructions système.
Cela fait 450 000 textes au total, que les chercheuses passent ensuite à travers plusieurs instruments.
- Detoxify et ToxiGen sont des classifieurs de toxicité « de surface » (surface-form classifiers). Ils repèrent les mots et tournures agressifs, comme un détecteur de fumée : efficaces sur un incendie, sans effet sur une fuite de gaz.
- REGARD ne mesure pas la toxicité. Il mesure l'attitude d'un texte envers un groupe démographique, c'est-à-dire la considération, positive ou négative, que le texte lui accorde.
- Un modèle BERTweet affiné pour détecter le sexisme, un analyseur de sentiment (Cardiff NLP RoBERTa) et un scoreur d'inférence logique (NLI) complètent l'ensemble.
- BERTopic est l'instrument central. C'est un outil de topic modeling qui regroupe automatiquement les textes par thème, comme un bibliothécaire qui rangerait 10 000 feuilles volantes en piles cohérentes sans consigne préalable. Il est appliqué séparément à chacune des 45 strates (15 modèles × 3 conditions), ce qui permet de comparer la bibliothèque « femmes » et la bibliothèque « hommes » de chaque modèle.
Un classifieur de toxicité juge chaque phrase isolément. Le topic modeling, lui, montre de quoi le modèle parle selon qu'il s'adresse aux femmes ou aux hommes, et aussi de quoi il ne parle pas.
Acte I : le ménage a bien été fait
Les chercheuses le reconnaissent : l'alignement a fonctionné sur ce qu'il visait. Dans les sorties de GPT-2 dirigées vers les femmes, BERTopic isole des clusters entiers consacrés à la violence sexuelle. Quinze clusters contenant « rape » ou « raped » apparaissent entre GPT-2 et text-davinci-002. À partir de GPT-4, il n'y en a plus aucun.
C'est un progrès réel, et c'est aussi le premier des trois critères que les autrices posent pour parler de harm laundering : le préjudice explicite doit décliner. S'il ne décline pas, il s'agit d'un modèle toxique ordinaire et il n'y a pas de blanchiment à chercher.
Acte II : les hommes héritent des nouvelles pièces de la maison
Le deuxième critère est celui du changement représentationnel asymétrique. Il est rempli quand le préjudice ne diminue pas mais se redistribue entre les groupes.
Entre GPT-2 et GPT-5, les complétions dirigées vers les hommes gagnent du « territoire représentationnel positif ». De nouveaux clusters y apparaissent : le soin aux autres (caregiving), la palette émotionnelle, l'identité d'allié. Dans ces textes, l'homme devient un personnage complexe et nuancé. Les complétions dirigées vers les femmes ne connaissent aucune expansion comparable.
La diversité thématique fait l'objet d'une mesure. Chez GPT-2, le ratio femmes/hommes du nombre de thèmes est de 0,91, soit presque la parité, dans un registre souvent sordide. Chez GPT-4, il tombe à 0,58. C'est une contraction de 36 %, qui se produit exactement à ce que les autrices appellent la « frontière d'alignement ». Le modèle est devenu poli avec les femmes, mais il dispose de beaucoup moins de sujets pour parler d'elles. On peut se représenter deux maisons voisines : l'une a été agrandie de plusieurs pièces, l'autre a seulement été repeinte.
Un autre chiffre va dans le même sens. Dans la condition « femmes », les complétions qui mentionnent deux identités à la fois, par exemple femme et noire ou femme et musulmane, passent de 30,84 % chez GPT-2 à 1,09 % chez GPT-4. Les chercheuses les qualifient d'intersectionnelles, en référence aux travaux de Kimberlé Crenshaw. Chez GPT-2, ces mentions n'étaient pas flatteuses. Leur quasi-disparition signifie cependant que le modèle a cessé d'aborder le sujet, ce qui est différent d'en parler mieux.
L'inversion du sentiment suit la même logique. Dans GPT-2 et GPT-3, les textes sur les hommes sont légèrement plus positifs que ceux sur les femmes (d de Cohen entre +0,03 et +0,10). À partir de GPT-4, l'écart se retourne nettement en faveur des femmes (d entre −0,31 et −0,57). Les autrices y voient une sur-correction : les anciens modèles rabaissent, les nouveaux encensent. Elles la résument ainsi : « l'affect positif monte pendant que le statut épistémique baisse ». Leur scoreur NLI suggère en effet que l'hypothèse « moins crédible ou moins compétente » remonte pour les femmes chez GPT-4, au moment même où le ton devient flatteur. Un compliment peut donc aller de pair avec une moindre prise au sérieux. Les autrices jugent toutefois cet instrument saturé sur leur corpus, et ce signal reste secondaire (voir les bémols plus bas).
Acte III : le cancer du sein, raconté aux hommes
L'exemple le plus marquant du papier se trouve chez GPT-5. Le deuxième plus gros cluster de la condition « hommes », le Topic 5, regroupe 1 997 documents. BERTopic l'a étiqueté automatiquement 5_men_can_get_breast. On y traite du cancer du sein sous l'angle « les hommes aussi peuvent en avoir », dans un cadrage proche du débat sur les droits des hommes et le féminisme. Les complétions typiques ressemblent à des listes de sujets : « Health: Can men get HPV or breast cancer? Mental health topics? ».
Pris isolément, ce contenu n'a rien de scandaleux. Les hommes peuvent effectivement développer un cancer du sein, et c'est une information médicale utile. Le problème se trouve dans l'autre bibliothèque. Côté femmes, aucun cluster ne mentionne le cancer du sein, le HPV ou le cancer du col de l'utérus. Un comptage direct le confirme : 701 mentions explicites du cancer du sein dans les sorties dirigées vers les hommes, soit 7 %, et zéro dans les sorties dirigées vers les femmes. La maladie qui touche massivement les femmes n'apparaît dans le corpus que lorsqu'il est question des hommes.
Cette asymétrie par absence remplit le troisième critère, celui de l'angle mort des classifieurs. Soumis aux détecteurs, le Topic 5 obtient 0,005 chez Detoxify, 0,001 chez ToxiGen et 0,180 sur l'échelle négative de REGARD. Les trois le jugent non toxique, et ce jugement est exact, puisque aucune phrase n'est agressive. Le préjudice tient à la répartition des sujets entre les deux conditions, et un classifieur qui lit phrase par phrase ne peut pas voir une absence.
La statistique qui résume le papier porte sur l'ensemble des quinze modèles. La disparité mesurée par REGARD est corrélée à la date de sortie (ρ = +0,55, p = 0,034) : plus le modèle est récent, plus l'écart de considération entre les genres est grand. Le score Detoxify, lui, ne montre aucune corrélation (ρ = −0,23, p = 0,42). L'indicateur que l'industrie met en avant ne bouge pas de façon significative, alors que celui que personne ne suit se dégrade.
Un test en trois critères, un protocole en trois étapes
Au-delà de la critique, le papier formalise le harm laundering par ses trois critères : déclin de l'explicite, redistribution asymétrique, angle mort des classifieurs. Il propose aussi un protocole de détection applicable à n'importe quel modèle génératif.
- Une évaluation de surface. On vérifie que la toxicité est faible. C'est la condition préalable, car on ne blanchit que ce qui a l'air propre.
- Un audit de la structure thématique. On applique BERTopic strate par strate et on cherche quels thèmes existent pour un groupe et pas pour l'autre.
- Une recherche de discordance entre classifieurs. On confronte un classifieur sensible à la démographie, comme REGARD ou un détecteur de sexisme, à un classifieur de surface. Un désaccord entre les deux signale un contenu à examiner.
Deux autres résultats méritent d'être relevés. Le premier concerne l'origine du phénomène : en comparant text-davinci-002 (affinage supervisé) et text-davinci-003 (premier modèle avec RLHF, l'apprentissage par renforcement sur retours humains), les autrices situent le point de bascule du côté du RLHF appliqué à grande échelle. Le second est plus encourageant : avec des instructions système, les signaux de blanchiment chez GPT-5 s'atténuent nettement. L'asymétrie de « cadrage équité » passe de +20,4 points à −0,9, et l'écart de référence croisée entre genres de +40,9 à +8,8 points. Le phénomène réagit donc au contexte, ce qui laisse penser qu'il n'a rien d'inévitable.
Pourquoi ce papier compte
La première raison est qu'il vise la méthode de mesure et non un modèle en particulier. Quand un laboratoire annonce « −X % de toxicité », il dit quelque chose de vrai sur une quantité trop étroite. C'est la loi de Goodhart : une mesure qui devient une cible cesse d'être une bonne mesure. À force d'optimiser contre des détecteurs de surface, on obtient des modèles très bons pour satisfaire ces détecteurs.
La deuxième raison est réglementaire. Les cadres d'audit qui se mettent en place, AI Act en tête, reposent largement sur ce type de benchmarks. Les autrices écrivent : « Surface-form audits will not catch this ». Si le préjudice se loge dans la structure des réponses, c'est-à-dire dans la répartition des sujets selon les publics, un audit phrase par phrase peut certifier un système qui ne le mérite pas.
La troisième raison est que ce travail prolonge une littérature existante. Dès 2021, Welbl et ses collègues montraient que la détoxification déplace les problèmes plus qu'elle ne les élimine. Barocas et Selbst décrivaient dès 2016 des systèmes qui reproduisent la discrimination derrière une neutralité de procédure. Ce papier y ajoute une série longitudinale de quinze modèles sur sept ans, et un nom pour désigner le phénomène.
Les bémols (et les autrices en listent douze)
La section limites est inhabituellement fournie, ce qui est à mettre au crédit du papier. Les principales :
- Corrélation n'est pas causalité. Entre GPT-2 et GPT-5, tout a changé : les données de pré-entraînement, l'instruction tuning, la taille des modèles, les filtres de modération de l'API. Les autrices discutent ces quatre explications concurrentes et tentent de les borner, avec la comparaison interne à GPT-3 et la condition neutre « people ». Attribuer l'effet au seul RLHF reste une inférence et non une preuve.
- Les statistiques reposent sur quinze points. Une corrélation de +0,55 avec p = 0,034 sur quinze modèles est un indice sérieux, sans plus. Les analyses par BERTopic comportent en outre une part stochastique. Les résultats sont déterministes avec une graine fixée, mais leur stabilité sous d'autres graines reste à vérifier.
- Les refus faussent l'échantillon. GPT-5 refuse 11,52 % des amorces dirigées vers les femmes contre 0,59 % côté hommes. Les textes analysés sont donc ceux qui ont passé ce filtre. Les autrices considèrent leurs chiffres comme une borne basse. Elles relèvent aussi que 61,5 % des refus côté femmes invoquent la sécurité, contre 27,6 % côté hommes, ce qui est en soi une asymétrie.
- Le scoreur NLI est saturé : il plafonne sur ce corpus. Les résultats sur la « crédibilité » sont donc explicitement exclus des analyses confirmatoires.
- Le résumé ne mentionne pas une nuance. Le taux de « discordance » (sexisme détecté par BERTweet mais toxicité faible selon Detoxify) baisse lui aussi, de 22 % chez GPT-2 à 0,4 % chez GPT-5. Même le détecteur de sexisme voit de moins en moins de choses. La thèse du papier est précisément que le préjudice a migré vers la structure thématique, hors de portée des classifieurs. En contrepartie, la démonstration repose surtout sur le topic modeling et sur l'interprétation humaine des clusters.
- La validité écologique est limitée. Personne n'utilise ChatGPT en tapant « Why are women so… ». Ces amorces sont des sondes et non des usages réels. Elles révèlent des dispositions du modèle, qui ne correspondent pas nécessairement à ce qu'un utilisateur observe en conversation.
- L'étude porte sur un seul fournisseur et sur un genre binaire : la lignée OpenAI, et la comparaison femmes/hommes. Les autrices le reconnaissent. Rien ne permet encore de dire si Claude, Gemini ou Llama se comportent de la même façon.
- Les données brutes ne sont pas publiées. Les complétions ne sont accessibles qu'aux chercheurs vérifiés, pour éviter de rediffuser du contenu nocif. Le code, les modèles BERTopic et les scores doivent être publiés.
Sur un autre plan, qualifier de « préjudice » le fait de parler du cancer du sein aux hommes et pas aux femmes relève d'un choix interprétatif. Ce choix est défendable, car l'asymétrie est nette. Un sceptique pourrait toutefois y voir un artefact des amorces : la question « est-ce que les hommes peuvent… » appelle naturellement des cas contre-intuitifs.
Ce qu'on va surveiller
Si ces résultats se confirment, réussir un test de toxicité ne dira plus grand-chose de la sécurité d'un modèle. Trois questions restent ouvertes. La première est la réplication sur d'autres familles de modèles, Claude, Gemini et les modèles ouverts, pour savoir si le harm laundering est propre à OpenAI ou s'il accompagne le RLHF en général. La deuxième est l'extension à d'autres axes que le genre : origine, handicap, âge, et leurs croisements. La troisième est la réaction de l'industrie : on verra si des audits de structure thématique apparaissent dans les system cards à côté des scores de toxicité, ou si les courbes actuelles continuent d'être publiées telles quelles.
Référence : Sarah Wyer, Sue Black, Noura Al Moubayed, Harm Laundering in GPT Models: Evidence That Gender Discrimination Is Transformed Rather Than Reduced Across Safety-Trained Generations, arXiv:2609.20779, déposé le 17 septembre 2026. Lire l'abstract sur arXiv.