System One Model : Jev, l'IA qui ne parle pas
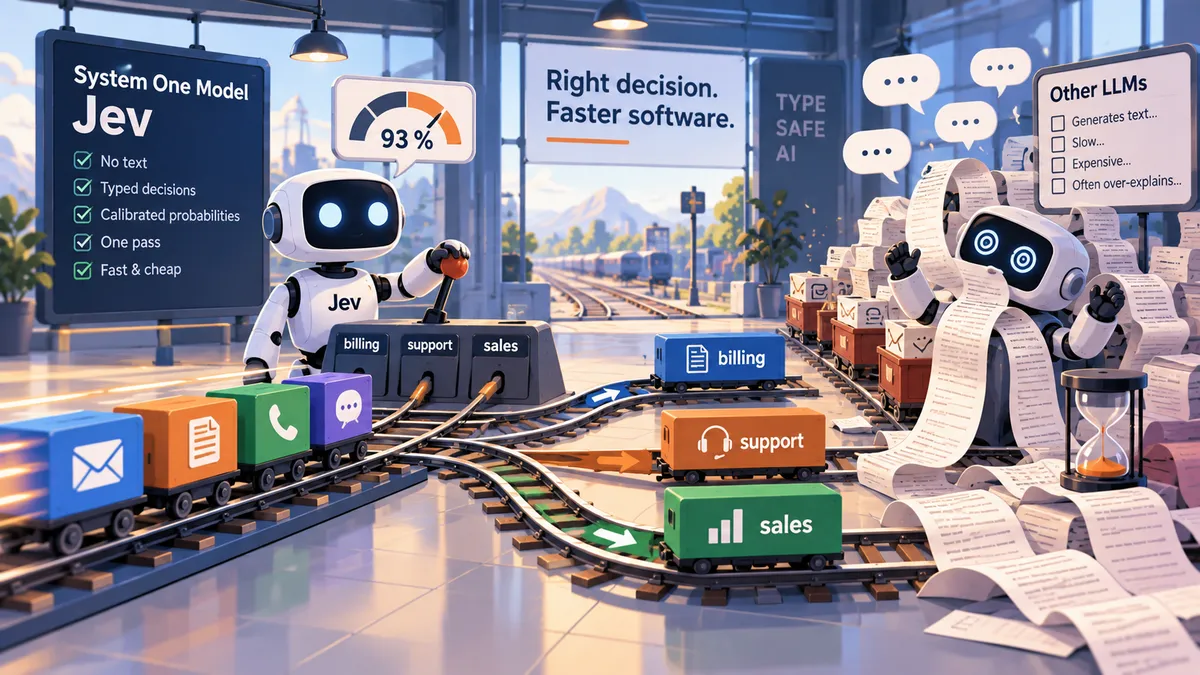
Prenez un service client. Un message arrive : « Ça fait trois fois que je vous écris, je veux être remboursé. » Pour savoir à qui le transmettre, l'entreprise moderne convoque un modèle de langage à plusieurs centaines de milliards de paramètres, lui explique poliment la situation, attend qu'il compose sa réponse syllabe par syllabe, reçoit {"category": "billing"}, vérifie que le JSON est bien formé, et croise les doigts pour que « billing » ne soit pas devenu « Billing department » en chemin.
C'est un peu comme poser une question fermée à un romancier : la réponse sera juste, probablement, mais vous aurez payé la prose.
Le 15 septembre 2026, TypeSafe AI, une startup de San Francisco sortie de deux ans de silence, a proposé autre chose : un modèle qui ne sait pas écrire. Il ne produit ni texte, ni code, ni explication. Jev (c'est son nom) répond à des programmes et non à des humains, par des décisions typées assorties d'une probabilité, en une centaine de millisecondes et pour un prix qui ressemble à une coquille.
Un avertissement avant d'aller plus loin, parce que la maison a ses habitudes : il n'existe pas de papier arXiv sur Jev, ni rapport technique, ni poids publiés. Cet article s'appuie donc sur le billet d'annonce, la documentation et la presse spécialisée. On y reviendra, car ce silence fait partie de l'histoire.
Système 1, Système 2 : le réflexe contre la dissertation
Le vocabulaire vient de Daniel Kahneman. Le Système 1 est la pensée rapide et intuitive (reconnaître un visage en colère, freiner devant un ballon). Le Système 2 est la pensée lente et délibérée (remplir sa déclaration d'impôts). La documentation de TypeSafe reprend la distinction telle quelle : « System 1 thinking is fast and intuitive. System 2 is slower and more deliberate. »
Le constat de Diogo Almeida, fondateur de TypeSafe et ancien chercheur d'OpenAI (TechCrunch le présente comme l'un des artisans de ChatGPT et du RLHF), tient en une phrase : toute l'industrie construit des Systèmes 2, des modèles qui raisonnent de plus en plus longtemps, alors que l'immense majorité des décisions prises à l'intérieur d'un logiciel relèvent du réflexe. Ce message est-il une demande de remboursement ? Cette commande shell est-elle dangereuse ? Cet e-mail est-il urgent ? Aucune de ces questions ne demande une dissertation. Il faut un if qui comprend le langage.
Sa formule, rapportée par The Register : « people can't be the only consumers of intelligence », les humains ne peuvent pas être les seuls consommateurs d'intelligence. D'où le concept maison de machine-native AI, une IA dont le client est une fonction plutôt qu'une personne.
Trois questions, pas une de plus
On envoie à Jev un état (du texte non structuré : un message, un log, la description d'une situation) et une ou plusieurs questions, chacune d'un type parmi trois :
- Noul, le booléen probabiliste. « Ce message demande-t-il un remboursement ? » →
{"noul": 0.93}. Jev ne répond pas « oui », il répond « oui à 93 % ». - Choice, un choix parmi des options fermées, avec la distribution complète :
{"choice": "billing", "probabilities": {"billing": 0.97, "support": 0.02, "sales": 0.01}, "confidence": 0.95}. - Score, une position sur une échelle ordonnée de 2 à 10 niveaux, par exemple la gravité d'un bug, avec une valeur interpolée (
1.3sur une échelle de 0 à 2) et la probabilité de chaque barreau.
L'appel ressemble à ceci (POST /v1/systemone, exemple simplifié, se reporter à la documentation pour les noms de champs exacts) :
{
  "model": "jev-latest",
  "state": {"message": "Ça fait trois fois que je vous écris, je veux être remboursé."},
  "questions": {
    "remboursement": {"type": "noul", "instructions": "Le client demande-t-il un remboursement ?"},
    "service":       {"type": "choice", "options": ["billing", "support", "sales"]},
    "frustration":   {"type": "score", "levels": 5}
  }
}
D'abord, toutes les questions sont traitées en une seule passe : TypeSafe parle d'un parallel sampler qui « generates all outputs in a single query ». Un LLM est autoregressive : il écrit un token (fragment de mot), le relit, écrit le suivant, comme quelqu'un qui dicterait une lettre mot à mot. Jev, lui, regarde la situation et abaisse tous ses leviers d'un coup. Ensuite, les tokens de sortie sont gratuits, ce qui est logique puisqu'il n'y en a pas vraiment.
« Mathématiquement impossible » : le dé qui ne fait jamais 7
L'argument marketing le plus tapageur est celui-ci : Jev serait hallucination-free, et les erreurs de type seraient « mathematically impossible ».
Il faut démonter la phrase en deux. La moitié vraie : si la sortie du modèle n'est pas un texte mais une distribution de probabilités sur une liste fermée d'options, alors il ne peut, par construction, rien répondre d'autre qu'une de ces options. Un dé à six faces ne fera jamais 7, et il n'a aucun mérite à cela : c'est sa géométrie. TypeSafe ne détaille pas le mécanisme, mais un indice traîne dans les limites annoncées : 255 choix maximum par question. Ce nombre sent fort la tête de classification encodée sur un octet, mais c'est une hypothèse de notre part, faute de papier pour la confirmer.
La moitié trompeuse, que The Register épingle sans ménagement : ne jamais sortir du schéma n'empêche pas de se tromper. « That does not preclude the possibility of being incorrect. » Jev ne répondra jamais « Billing department », certes. Mais il peut parfaitement répondre billing à un message qui relevait du support. Le dé ne fait jamais 7, mais rien ne dit qu'il tombe sur la bonne face.
La calibration : un modèle qui sait quand il doute
Le cœur technique de Jev est sans doute la calibration.
Un modèle est calibré quand ses probabilités veulent dire quelque chose. L'image classique est celle du présentateur météo : s'il annonce « 70 % de risque de pluie » cent jours dans l'année, il doit pleuvoir environ soixante-dix de ces jours-là, et non cinquante ou quatre-vingt-quinze. Un présentateur calibré peut se tromper aujourd'hui, mais sur la durée ses pourcentages sont honnêtes.
Or les LLM sont de piètres météorologues. Demandez à un modèle conversationnel s'il est sûr de lui : il répondra avec le même aplomb qu'il ait raison ou tort, et les techniques d'alignement classiques (le fameux RLHF, qui optimise ce qui plaît à un évaluateur humain) ont plutôt tendance à aggraver les choses.
TypeSafe dit avoir remplacé cette étape par une méthode maison, RLCD (Reinforcement Learning for Calibrated Decisions), qui optimise selon ses termes des réponses aux « epistemically honest probabilities », des probabilités « optimized against outcomes to reflect uncertainty ». D'après TechCrunch, l'entraînement repose exclusivement sur des données synthétiques. C'est à peu près tout ce que l'on sait.
L'intérêt pratique est considérable. Un 0.93 fiable permet d'écrire : au-dessus de 0,9, on automatise ; entre 0,6 et 0,9, on escalade vers un gros modèle ; en dessous, un humain regarde. Nikhil Mudholkar, CTO de Bryo AI, résume ce qui l'a convaincu : Jev est « the only one that hands back a real probability ».
La documentation a l'honnêteté de préciser la limite, et elle est de taille : la calibration est une propriété d'ensemble, elle « does not guarantee that an individual answer is correct ». Armin Ronacher (créateur de Flask, aujourd'hui CTO d'Earendil) le dit autrement : c'est désormais au développeur d'interpréter les scores de confiance. Le doute devient une donnée d'entrée, encore faut-il en faire quelque chose.
Les chiffres : Doom, Wikipédia et le prix d'un café
Côté performances, TypeSafe annonce :
- 70 à 500 ms de latence de bout en bout, contre 3 à 329 secondes pour les LLM de référence sur les mêmes tâches. Dans la démo officielle relevée par The Register : 0,114 s contre 8,566 s.
- 0,042 $ par million de tokens d'entrée, sortie gratuite, là où les LLM facturent entre 0,20 et 10 $.
- Sur quatre workflows de production rejoués en interne : 193,6 fois plus rapide et 444,6 fois moins cher que les modèles frontière de comparaison.
La démo qui a fait le tour des réseaux est un bot qui joue à Doom en temps réel, à dix décisions par seconde, pour environ 7 $ de l'heure. Jev ne voit pas l'écran, puisqu'il n'accepte que du texte : il reçoit l'état du jeu sous forme structurée (positions, points de vie, ennemis). Une seconde démo, le wikiracing (rallier une page Wikipédia à une autre en cliquant de lien en lien), montre l'autre bout du spectre : beaucoup d'options par décision, et des gains de vitesse nettement moins spectaculaires, de l'aveu même de l'éditeur.
Les premiers retours de terrain cités par TechCrunch sont moins flamboyants mais plus crédibles. Chez Vercel, Pranit Sharma rapporte des classifieurs de sécurité 5 à 18 fois plus rapides, avec une meilleure exactitude, après remplacement d'un LLM par Jev. Chez Bryo AI, le tri d'e-mails revient 10 à 20 fois moins cher qu'avec Gemini. On est loin du « 444 fois », et c'est très bien : ce sont des chiffres de gens qui paient la facture.
Pourquoi cette annonce compte
Parce qu'elle prend à rebours le récit dominant. Depuis deux ans, le progrès se mesure en minutes de réflexion : des modèles qui pensent plus longtemps, des agents qui enchaînent les étapes. Jev rappelle que, dans un système en production, la plupart des appels à un LLM sont des aiguillages et non des problèmes de raisonnement. Il s'agit de filtrer, router, noter, détecter, y compris autour des agents eux-mêmes : surveiller leurs traces, bloquer un jailbreak, choisir vers quel modèle envoyer une requête.
Le développeur Flavio Copes a la formule juste : Jev ne remplace pas un agent, il remplace un if ordinaire par un if intelligent. Et il fait le calcul que tout le monde devrait faire : si la classification pèse 60 % de votre facture LLM et que Jev coûte 5 % du modèle remplacé, l'économie totale est de 57 %, et non de 99 %.
Reste le nom. « Jev » rend hommage à William Stanley Jevons, l'économiste qui observa au XIXᵉ siècle que des machines à vapeur plus sobres en charbon faisaient exploser la consommation de charbon. TypeSafe parie que l'intelligence machine suivra le même chemin : rendez la décision cent fois moins chère, et les logiciels en consommeront mille fois plus, à des endroits où personne n'aurait songé à mettre un LLM, comme une boucle de jeu, un pare-feu ou un tri de logs.
Les bémols : une boîte noire qui vous demande de la croire sur parole
Ils sont nombreux, et le premier conditionne tous les autres.
Il n'y a pas de papier, pas de poids publiés, pas de taille annoncée. L'architecture n'est pas décrite (TechCrunch note qu'on la soupçonne bâtie sur un LLM open-weight), RLCD tient en une phrase, le parallel sampler en deux. Le billet d'annonce affiche même une FAQ (« Why was a new training algorithm needed? ») dont la réponse vaut surtout par sa brièveté. Pour un modèle dont l'argument central est l'honnêteté épistémique, c'est cocasse.
Les benchmarks sont faits maison. Les quatre workflows d'évaluation ont été conçus par l'équipe, qui le reconnaît et précise que ses chiffres se situent « on the higher end of real world gains ». La calibration elle-même, la promesse la plus importante, n'a été vérifiée par aucun tiers. Or c'est une propriété qui se mesure sur vos données : un modèle calibré sur des tickets de support synthétiques ne l'est pas forcément sur vos contrats d'assurance.
Il y a aussi un match qui n'a pas été joué. TypeSafe compare Jev aux gros LLM généralistes, alors que ses concurrents naturels sont ailleurs : les structured outputs avec décodage contraint, qui garantissent eux aussi un JSON conforme ; les logprobs que l'on peut recalibrer ; et surtout le bon vieux classifieur spécialisé, un petit modèle de type BERT affiné sur quelques milliers d'exemples, qui tourne en quelques millisecondes pour un coût dérisoire. L'avantage de Jev est d'être zero-shot : pas de données à étiqueter, une instruction suffit. C'est un vrai argument, qui mériterait un vrai banc d'essai.
Les limites fonctionnelles sont nettes : texte uniquement, 255 options maximum, un contexte d'environ 64 000 tokens. S'y ajoutent, d'après les essais de Flavio Copes, une arithmétique peu fiable (compter, comparer des nombres) et une sensibilité aux formulations tordues, doubles négations ou questions inversées. Un Système 1, en somme : brillant sur l'évidence, fragile dès qu'il faudrait réfléchir. Kahneman n'aurait pas dit mieux.
Reste une question qui dépasse la technique. The Register conclut son article par une pique qui reste en tête : si Jev joue à Doom aussi bien et pour aussi peu cher qu'annoncé, combien de temps avant qu'on lui demande des décisions de ciblage pour drones ? Une IA conçue pour décider sans qu'aucun humain ne lise la réponse, c'est exactement la définition du produit, et c'est aussi celle du problème.
Ce qu'on va surveiller
D'abord, un rapport technique. Tant que RLCD reste un acronyme, la communauté ne peut ni reproduire, ni critiquer, ni améliorer. Une évaluation indépendante de la calibration, avec de vrais diagrammes de fiabilité, vaudrait toutes les démos de Doom.
Ensuite, la réplique. Armin Ronacher note que si personne n'avait creusé cette voie, c'est que les LLM étaient « so cheap and subsidized » que l'ingéniosité n'était pas nécessaire. Si la voie est bonne, les grands laboratoires et l'open source y seront dans six mois, et il est probable qu'un arXiv finisse par décrire ce que TypeSafe garde pour lui.
Enfin, l'architecture des applications. Un monde où les logiciels combinent un Système 1 à 100 ms pour les réflexes et un Système 2 à 30 secondes pour les cas que le premier déclare douteux ressemble furieusement à un cerveau.
En attendant, la leçon vaut pour tous ceux qui branchent un LLM dans un if : avant de chercher le modèle le plus intelligent, se demander de combien d'intelligence cette décision a besoin, et si l'on est capable de savoir quand elle en manque.
Sources. Il n'existe pas, à la date du 20 septembre 2026, de publication arXiv décrivant Jev. Source primaire : Introducing System One Models & Jev, TypeSafe AI (Diogo Almeida et l'équipe TypeSafe), 15 septembre 2026, typesafe.ai/blog/introducing-system-one-models-and-jev ; documentation : docs.typesafe.ai/concepts/system-one. Compléments : The Register, « TypeSafe AI debuts model for machines that plays Doom », 16 septembre 2026 ; TechCrunch, « A new kind of AI model from a ChatGPT inventor is thrilling developers », 18 septembre 2026 ; Flavio Copes, « A deep dive into Jev, TypeSafe's System One model ».