Optimisation logicielle par agent IA
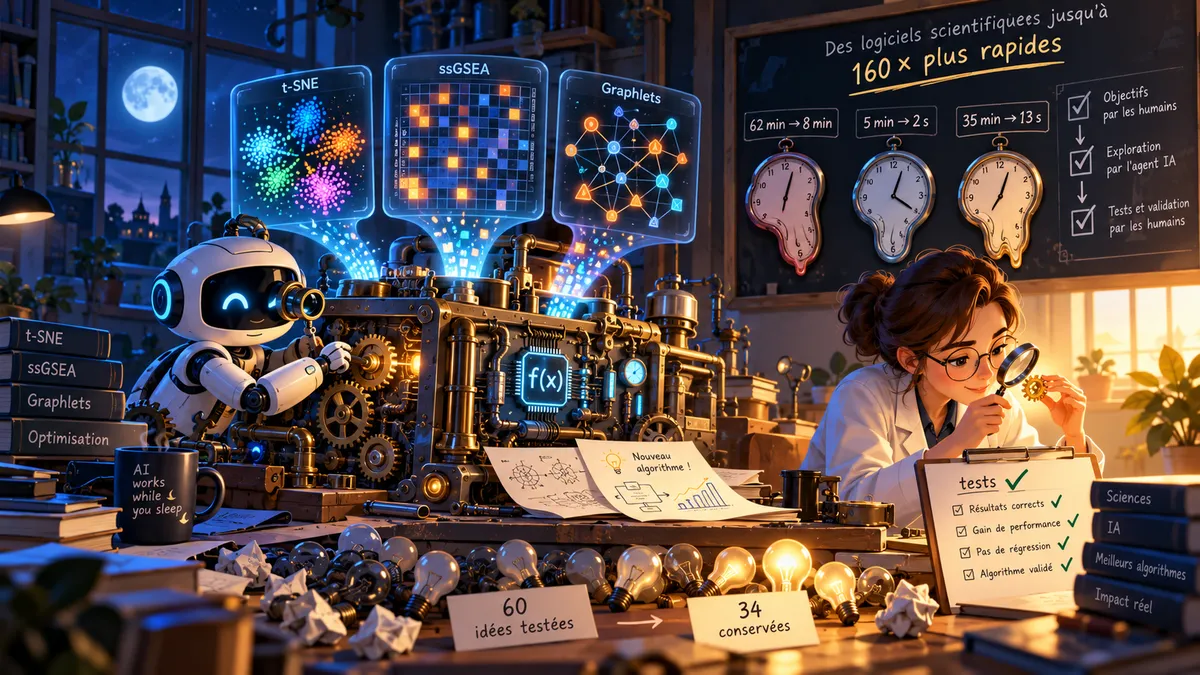
Prenez un logiciel scientifique que son auteur a peaufiné pendant des années. Il a traqué les copies mémoire inutiles, parallélisé les boucles et intégré les meilleures approximations publiées. Le code est rapide et sert dans des milliers d'analyses. Un soir, on le confie à un agent IA avec une consigne simple : « rends-le plus rapide, sans rien casser ». Le lendemain matin, le calcul qui prenait une heure en demande huit minutes.
C'est l'une des trois expériences décrites dans Is manual software optimization a thing of the past?, déposé sur arXiv le 29 septembre 2026 par Pavlin G. Poličar, Martin Špendl et Tomaž Hočevar. La question du titre est volontairement provocante. La réponse des auteurs est plus mesurée qu'un « oui » franc, mais elle a de quoi faire réfléchir quiconque a déjà passé une semaine devant un profiler.
Le contexte : la science tourne sur du code
Les données scientifiques grossissent plus vite que la patience des chercheurs. En biologie, un jeu de données de cellules uniques se compte en centaines de milliers d'échantillons, et les réseaux d'interactions entre protéines en centaines de milliers de liens. Les outils qui les traitent doivent suivre.
Optimiser un logiciel, c'est-à-dire le rendre plus rapide sans changer ce qu'il calcule, relève traditionnellement de l'artisanat de haut niveau. Il faut connaître le fonctionnement fin du processeur et de la mémoire, maîtriser l'algorithmique et parfois retravailler les équations elles-mêmes. Peu de laboratoires emploient ces profils. Les auteurs rappellent qu'une bonne partie du logiciel scientifique est écrite par des chercheurs dont ce n'est pas le métier, et que beaucoup de projets n'ont pas les moyens de s'offrir des spécialistes du calcul numérique ou de la conception d'algorithmes.
D'où la question du papier : un agent fondé sur un grand modèle de langage (LLM-based agent, c'est-à-dire un modèle qui ne se contente pas de répondre mais agit, lit du code, le modifie, lance des tests et recommence) peut-il faire ce travail seul ? Et pas seulement sur du code amateur, mais aussi sur des outils déjà optimisés avec soin par des humains ?
Le protocole : les humains posent le cadre, l'agent travaille
Le dispositif tient en quelques lignes, et c'est justement ce qui le rend intéressant. L'agent utilisé est Claude Opus 5 piloté via Claude Code. Pour chaque problème, les humains font trois choses :
- définir le périmètre : quelle partie du code optimiser et ce qui ne doit pas bouger (API publique, paramètres par défaut, précision) ;
- fixer les critères de correction : ce que « donner le bon résultat » veut dire, par exemple des scores identiques à ceux des bibliothèques de référence ;
- fournir un mécanisme de vérification, une batterie de tests ou une implémentation de référence contre laquelle l'agent peut se contrôler seul.
Ensuite, on s'en va. L'agent travaille « en autonomie, dans certains cas pendant plusieurs heures », et même toute une nuit pour l'un des cas. À la fin, les mainteneurs du code, des experts du domaine dont certains ont écrit les outils d'origine, relisent le résultat et vérifient qu'il est correct.
On peut comparer cela à un concours de cuisine à l'aveugle. Le jury fixe la recette et le goût attendu, puis vérifie le plat à la fin. Il ne dit jamais au cuisinier comment tenir son couteau.
Trois terrains d'essai ont été choisis, trois outils très utilisés dans la recherche.
Cas n°1 : t-SNE, ou l'art de ranger des points dans un plan
t-SNE (t-distributed Stochastic Neighbor Embedding) sert à visualiser des données à très haute dimension. Chaque cellule d'un échantillon biologique est par exemple décrite par l'expression de 20 000 gènes, et t-SNE en tire une carte en deux dimensions où les points semblables se regroupent. Imaginez un plan de table de mariage : on place les invités de façon que ceux qui s'entendent bien soient voisins. On part d'un placement au hasard, puis on déplace tout le monde petit à petit en fonction des attirances et des répulsions entre chacun.
Ce calcul de forces entre tous les points coûte très cher. On utilise donc des approximations. Barnes-Hut regroupe les points lointains en « paquets » vus de loin, comme on traite une foule au fond de la salle comme un seul bloc. FIt-SNE passe par une grille et des transformées de Fourier rapides.
L'outil de référence est openTSNE, que les auteurs décrivent comme une implémentation CPU « mature et fortement optimisée ». Pavlin Poličar, premier auteur du papier, en est le développeur. La mission de l'agent portait sur la phase d'optimisation de l'algorithme, qui représente 80 à 90 % du temps d'exécution, sans toucher à l'API ni aux paramètres par défaut et sans perdre en précision. Son filet de sécurité : les 174 tests unitaires du projet, relancés après chaque modification. Seules les améliorations mesurées étaient conservées.
Pendant la nuit, l'agent a implémenté et évalué environ 60 idées d'optimisation et en a gardé 34. Voici les résultats sur 500 000 points :
- en mono-thread avec Barnes-Hut, on passe de 62 minutes à 8 minutes ;
- en mono-thread avec FIt-SNE, de 9 minutes à 2 minutes ;
- sur 8 threads avec Barnes-Hut, de 12 minutes à moins de 2 minutes ;
- sur 8 threads avec FIt-SNE, de 140 secondes à 28 secondes.
Au total, le gain va de 4,4× à 7,7× selon la configuration. Il vient pour l'essentiel d'améliorations classiques : des chemins de code spécialisés pour les cas fréquents, une meilleure disposition des données en mémoire (memory layout, qui revient à ranger les ingrédients dans l'ordre où on s'en sert pour ne pas courir sans cesse au placard), et davantage de parallélisme. S'y ajoute une trouvaille plus mathématique : une simplification d'une étape de l'approximation FIt-SNE qui réduit le temps de cette étape d'environ 25 %.
Les auteurs précisent qu'aucune de ces modifications ne change la complexité asymptotique de l'algorithme. La façon dont le temps de calcul grandit avec la taille des données reste la même. Le cuisinier n'a pas changé de recette, il a réorganisé sa cuisine. Mais sur un code que son propre auteur croyait déjà bien affûté, diviser le temps par six reste remarquable.
Cas n°2 : ssGSEA, ou le calcul qu'on savait accélérer sans l'avoir fait
Deuxième terrain, la bio-informatique pure. ssGSEA (single-sample Gene Set Enrichment Analysis) donne à chaque échantillon un score par « ensemble de gènes », c'est-à-dire par groupe de gènes associés à une même fonction biologique (la réponse immunitaire, le cycle cellulaire, etc.). En gros, on se demande si les gènes de ce groupe sont plutôt en haut ou en bas du classement dans cet échantillon.
Deux outils de référence ont servi de comparaison. GSEApy est l'implémentation la plus rapide que les auteurs aient trouvée. GSVA utilise une expression en forme fermée (closed-form, une formule directe au lieu d'un calcul pas à pas) qui devrait en théorie changer la façon dont le coût évolue, mais son implémentation n'en tire pas ce bénéfice. Le gain existe sur le papier et personne ne l'avait encore obtenu en pratique.
L'agent devait écrire une nouvelle implémentation dont les scores sont exactement identiques à ceux des bibliothèques existantes. Il est parti de la formule fermée de GSVA et a reformulé tout le calcul comme une multiplication de matrice creuse (sparse matrix multiplication). Une matrice creuse est un grand tableau presque entièrement rempli de zéros. Les bibliothèques savent sauter ces zéros, un peu comme on ne lit que les cases cochées d'un questionnaire au lieu de parcourir les cases vides une par une. Cette réécriture a enfin permis d'obtenir le gain asymptotique promis par la théorie.
Le résultat : pour 2 000 ensembles de gènes sur 1 000 échantillons, GSEApy met 5 minutes et la version de l'agent 2,2 secondes, soit une accélération de 136×. L'écart augmente encore avec le nombre d'ensembles de gènes.
Les auteurs soulignent la conséquence pratique. Jusqu'ici, les analystes présélectionnaient souvent quelques ensembles de gènes « intéressants » parce que tout scorer prenait trop de temps. Avec ce gain, on peut scorer des collections entières. Un compromis méthodologique imposé par la puissance de calcul disparaît.
Cas n°3 : le comptage de graphlets, et un algorithme que personne n'avait trouvé
Le troisième cas est le plus frappant. Un graphlet est un petit motif de quelques nœuds reliés entre eux dans un grand réseau : un triangle, une étoile, un carré, etc. (le papier traite des graphlets allant jusqu'à cinq nœuds). Compter pour chaque nœud dans quels motifs il apparaît, et à quelle position (son orbite : le centre de l'étoile n'occupe pas la même place qu'une branche), donne une sorte d'empreinte digitale de son voisinage. En biologie des réseaux, c'est un outil classique pour comparer des protéines selon leur place dans le réseau d'interactions.
L'outil de référence est Orca, très utilisé, dont Tomaž Hočevar, dernier auteur du papier, est l'un des créateurs. Pour mesurer les enjeux, voici les complexités avec n le nombre de nœuds et d le degré maximal (le nombre de voisins du nœud le plus connecté) :
- l'énumération brute, qui passe en revue tous les motifs un par un, coûte O(nd⁴) ;
- Orca coûte O(nd³) ;
- l'implémentation de l'agent coûte O(nd²).
Il s'agit d'un algorithme entièrement nouveau, et non d'un réglage fin : il gagne un facteur d sur l'état de l'art. Pour se représenter la différence : si le nœud le plus connecté a 1 000 voisins, un facteur d vaut à peu près mille fois moins de travail dans le pire cas.
Sur des données réelles, le réseau d'interactions protéine-protéine humain de BioSNAP (environ 22 000 nœuds et 340 000 arêtes), Orca met 35 minutes et la version de l'agent 13 secondes, environ 160× plus vite. L'énumération brute prendrait selon les estimations 3,5 jours, soit environ 20 000 fois plus que l'agent. Sur des graphes aléatoires de 10 000 nœuds, plus le réseau est dense, plus l'écart grandit : le temps de calcul croît de façon quartique pour la méthode brute, cubique pour Orca et quadratique pour l'agent.
Là encore, le critère de correction était strict : des comptes exactement identiques à ceux d'Orca et de l'énumération brute.
Pourquoi ce papier compte
On a déjà vu beaucoup de démonstrations d'IA qui « codent ». La plupart portent sur des tâches neuves ou des exercices calibrés. Ce papier se distingue sur trois points.
D'abord, les adversaires sont sérieux. L'agent ne s'attaque pas à un script écrit à la va-vite. Il affronte des outils mûrs, publiés et utilisés, dont deux ont été conçus par les auteurs eux-mêmes, des gens qui savent optimiser. Battre openTSNE d'un facteur 4 à 8 et Orca d'un facteur 160 n'a rien d'une victoire facile.
Ensuite, les gains sont de natures très différentes. Les trois cas montrent trois niveaux d'intervention : l'optimisation de bas niveau (t-SNE), la reformulation mathématique (ssGSEA) et l'invention algorithmique (graphlets). On imaginait les agents capables de faire la plomberie. Ils touchent aussi aux mathématiques et à la conception d'algorithmes.
Enfin, le rôle humain change. C'est la thèse centrale des auteurs : l'humain n'écrit plus les optimisations, il décide quel logiciel optimiser, définit le périmètre et les objectifs, fournit les mécanismes de vérification et garantit que le logiciel final est correct. Dans ce modèle, l'optimiseur ressemble moins à l'artisan qu'à l'architecte qui rédige le cahier des charges et au contrôleur qui réceptionne le chantier.
Pour la recherche, l'enjeu est concret. Des milliers de laboratoires utilisent des outils écrits par des chercheurs pressés, sans spécialiste du calcul haute performance à disposition. Si l'optimisation devient une tâche qu'on délègue la nuit, la puissance de calcul dont dispose la science augmente sans acheter un seul serveur de plus. Les auteurs mettent d'ailleurs à disposition leurs prompts d'optimisation réutilisables, les nouvelles implémentations et le matériel de réplication sur GitHub.
Les bémols : ce que le papier ne dit pas (encore)
Il faut maintenant nuancer, car ce papier en laisse la place.
Le cadre est très favorable. Les auteurs le reconnaissent : leurs conclusions valent pour des problèmes « bien délimités et vérifiables ». Les problèmes aux objectifs flous ou dont la correction est difficile à vérifier « restent non testés ». Or les trois cas choisis sont presque idéaux : une réponse exacte connue d'avance, des implémentations de référence pour comparer au chiffre près, une suite de 174 tests. Beaucoup de logiciels scientifiques n'ont ni tests complets ni vérité de référence. Et lorsqu'un calcul est stochastique ou approximé, dire ce qui est « correct » devient beaucoup plus délicat.
Il n'y a que trois cas, et seulement des succès. Trois études de cas, choisies par les auteurs, ne font pas une statistique. Le papier ne raconte pas de tentative ratée, d'impasse ou de cas où l'agent aurait tourné en rond. On aimerait savoir combien d'expériences ont été lancées avant de retenir ces trois-là, et ce que l'agent produit sur un code dont personne ne connaît aussi bien les recoins.
Les juges sont aussi parties. La relecture par les mainteneurs fait la force du protocole : qui connaît mieux openTSNE que son auteur ? C'est aussi une limite. Les mainteneurs sont ici les auteurs du papier, avec l'enthousiasme qu'on devine. Une validation par des équipes indépendantes serait bienvenue.
Le texte est court et peu détaillé. La version disponible ne décrit ni le matériel des benchmarks, ni le coût d'utilisation de l'agent (tokens, facture d'API), ni le fonctionnement du nouvel algorithme de graphlets, ni le contenu exact de la simplification FIt-SNE. Pour un résultat aussi fort qu'un nouvel algorithme en O(nd²), on attend une description formelle et une preuve de correction, pas seulement des comptes identiques sur des jeux de test. Une partie de ces éléments se trouve peut-être dans le dépôt GitHub, mais le papier lui-même reste succinct.
Le coût humain en amont est réel. L'agent travaille seul, mais seulement après qu'on lui a fourni un périmètre clair et un mécanisme de vérification solide. Dans la vraie vie, écrire la batterie de tests qui permet de faire confiance au résultat représente souvent la moitié du travail. Le papier déplace l'expertise plutôt qu'il ne la supprime.
Et maintenant ?
Faut-il déjà écrire l'épitaphe de l'optimisation manuelle ? Les auteurs eux-mêmes ne vont pas jusque-là : ils disent qu'elle « pourrait » appartenir au passé, pour les problèmes bien délimités et vérifiables. Cette réserve compte, et elle indique la compétence qui va prendre de la valeur : savoir spécifier et vérifier. Formaliser ce que « correct » veut dire, construire des oracles de test, choisir les bons benchmarks. Autrement dit, l'optimiseur de demain passera peut-être moins de temps sur ses boucles et davantage sur ses tests.
Plusieurs choses seront à surveiller dans les mois qui viennent :
- la réplication indépendante : d'autres équipes, sur d'autres logiciels, avec des mainteneurs qui ne sont pas coauteurs ;
- les cas difficiles : codes sans tests, calculs stochastiques, objectifs multiples (vitesse, mémoire, lisibilité), où la vérification n'est plus binaire ;
- la maintenabilité : un code optimisé par une machine en une nuit reste-t-il compréhensible et modifiable par des humains dans deux ans ?
- l'algorithme de graphlets lui-même : s'il tient, il mérite sa propre publication et sa propre analyse théorique, ce qui serait un joli retournement pour une idée née d'une nuit de calcul.
Si ces résultats se confirment, l'optimisation d'un logiciel scientifique ressemblera à ce qui s'est passé ici : on fixe le cahier des charges et les tests en fin de journée, l'agent travaille pendant la nuit, et on vérifie son travail le lendemain matin.
Référence : Pavlin G. Poličar, Martin Špendl, Tomaž Hočevar, Is manual software optimization a thing of the past?, arXiv:2609.37849, déposé le 29 septembre 2026. https://arxiv.org/abs/2609.37849