AI agents reshape consensus formation — Consensus homme-IA : passé un certain seuil, ce sont les agents qui dictent le vocabulaire du groupe
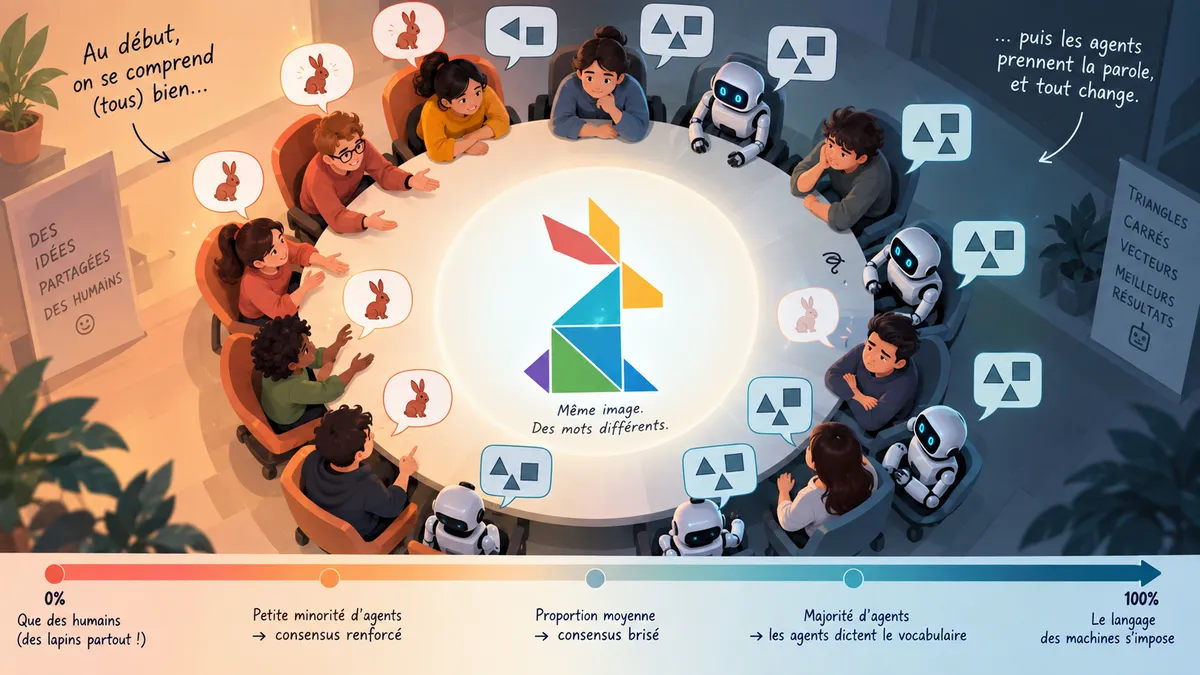
Imaginez un jeu de société un peu étrange. Vingt-quatre joueurs, une seule image abstraite projetée sur tous les écrans, et à chaque tour, un tirage au sort vous attribue un partenaire. Vous ne parlez pas. Chacun tape une phrase pour décrire l'image, puis on vous montre la phrase de l'autre et un score qui mesure à quel point vous dites la même chose. Plus vous êtes proches, plus vous gagnez. Quarante tours plus tard, le groupe a en général inventé, sans jamais se concerter, une façon commune de nommer ce gribouillis.
Maintenant, ajoutez une règle : certains joueurs sont des modèles de langage. On vous a prévenu qu'ils existent, mais pas combien ils sont, ni qui ils sont. Question : qui, à la fin, aura imposé sa manière de voir l'image ?
C'est exactement le dispositif de « AI agents reshape consensus formation in human groups », déposé sur arXiv le 2 septembre 2026 par Lin Chen, Ziyi Liu, Xia Hu et Yong Li. Et la réponse n'est pas une courbe bien sage. C'est une histoire en trois actes, avec un retournement final où les humains, tout en désapprouvant le résultat, finissent par parler comme les machines.
Un lapin, des triangles et un score de similarité
Le matériau du jeu est un tangram, ces figures géométriques faites de quelques polygones assemblés, tirées du jeu de données KiloGram. Les auteurs en ont choisi un seul pour toutes les sessions, calibré pour être « moyennement ambigu » : suffisamment suggestif pour qu'on y voie quelque chose, suffisamment flou pour que tout le monde n'y voie pas la même chose. C'est la matière première idéale pour observer la naissance d'une convention. Le protocole descend d'une tradition bien établie en psychologie expérimentale, celle des jeux de communication référentielle de Clark et Wilkes-Gibbs, puis des expériences de Centola et Baronchelli sur l'émergence spontanée des conventions.
Concrètement : 127 étudiants d'universités chinoises, répartis en sessions de 24 joueurs, 40 tours, une phrase en anglais par tour, un temps conseillé de 60 secondes. Le score de similarité affiché après chaque tour est converti en argent, entre -1 et +2 yuans par tour, plafonné à 100 yuans. Rien n'impose une stratégie de description ; le score sert seulement de boussole.
Les agents sont des modèles Qwen2.5-VL, en version 32 milliards de paramètres pour l'expérience principale et 7 milliards pour une comparaison. Ils reçoivent les règles du jeu, l'image, la consigne de maximiser leurs points, et à chaque tour la description de leur partenaire précédent. Ils ne savent pas s'ils jouent avec un humain ou une autre machine. Les humains, eux, savent qu'il y a des IA dans la salle, mais ignorent leur nombre.
Cinq configurations ont été testées : 0 % d'agents (24 humains), 12,5 % (21 humains), 33,3 % (16 humains), 50 % (12 humains) et 75 % (6 humains).
Pour mesurer si le groupe converge, les auteurs plongent chaque phrase dans un espace vectoriel avec le modèle d'embeddings all-MiniLM-L6-v2 et calculent une « force de consensus » (consensus strength), en gros la proximité moyenne des descriptions à un moment donné. Image mentale : chaque phrase est un point sur une carte, et on regarde si le nuage de points se resserre au fil des tours.
Acte I : un peu d'IA, et le groupe humain converge mieux
Avec 12,5 % d'agents, soit trois machines parmi 21 humains, le consensus final est plus fort qu'avec un groupe purement humain : +8 % de force de consensus. Et le plus intéressant est le sens du mouvement. Sur la carte, ce sont les agents qui se déplacent vers les humains, pas l'inverse : leur « rapprochement directionnel » atteint 0,822 contre 0,575 pour les humains. Les auteurs parlent de consensus humain « facilité par les agents » (agent-facilitated human consensus).
Pourquoi une minorité de machines aide-t-elle ? Parce qu'elles sont d'excellentes suiveuses. Placées face à un partenaire humain, elles reprennent volontiers son expression, et comme elles sont stables d'un tour à l'autre, elles agissent comme des répétiteurs : elles propagent les formulations humaines dominantes plus vite que ne le feraient des humains, qui, eux, changent d'avis et de tournure.
Acte II : la zone de turbulence
À 33,3 % et 50 % d'agents, tout se dérègle. La force de consensus chute de 23,1 % à un tiers d'agents, et de 14,5 % à moitié-moitié. Le groupe ne parvient plus à se mettre d'accord.
Le mécanisme ressemble à un remorqueur pris entre deux courants. D'un côté, les humains tirent vers leurs descriptions imagées. De l'autre, les agents, qui partagent entre eux un même « prior linguistique » (nous y reviendrons), tirent vers leurs formulations géométriques. À ces proportions, aucune des deux forces ne domine, et le nuage de points reste éclaté. Fait notable : dans cette zone, ce sont déjà les humains qui bougent le plus vers les agents, sans que cela suffise à produire un consensus.
Les auteurs ont testé cette lecture en manipulant le comportement des agents à 33,3 %. En les rendant plus dociles (forte adoption des expressions du partenaire), le consensus se maintient, mais l'influence conceptuelle des agents s'effondre de 42,8 %. En les rendant plus têtus (forte persistance), leur influence conceptuelle bondit de 117,8 %, mais le consensus recule encore de 9,6 %. Autrement dit : un agent influent doit à la fois adopter tôt et persister tard, et c'est ce cocktail qui, à proportion intermédiaire, empêche le groupe de se stabiliser.
Autre test parlant : en remplaçant le modèle de 32 milliards de paramètres par sa version à 7 milliards, toujours à 33,3 %, le consensus remonte à 0,725, à peu près le niveau du régime facilité. Le petit modèle, incapable de maintenir une expression cohérente d'un tour à l'autre, ne fait plus contrepoids. Le chaos intermédiaire n'est donc pas une fatalité de la proportion : c'est le produit d'agents suffisamment compétents pour tenir leur ligne.
Acte III : le consensus revient, mais ce n'est plus le nôtre
À 75 % d'agents, six humains parmi dix-huit machines, la force de consensus remonte à 0,725, comparable au régime à 12,5 %. Vu de loin, tout va bien : le groupe s'est mis d'accord. Mais la direction du mouvement s'est complètement inversée. Ce sont désormais les humains qui migrent vers l'espace linguistique des agents. Le consensus est « dirigé par les agents » (agent-led consensus).
Et là, le papier prend une dimension qui dépasse la mécanique des scores. Les auteurs ont comparé le contenu des conventions finales entre le régime humain et le régime agent, sur cinq dimensions :
| Dimension | Consensus humain (12,5 %) | Consensus agent (75 %) |
|---|---|---|
| Concrétude (échelle 1-5, lexique de Brysbaert) | 2,99 | 2,72 |
| Densité d'idées (propositions pour dix mots) | 5,42 | 5,32 |
| Ratio d'analogie (l'image évoque un objet réel) | 0,80 | 0,05 |
| Ratio holistique (la figure vue comme un tout) | 0,69 | 0,35 |
| Cadrage en événement (la figure fait quelque chose) | 0,39 | 0,00 |
Les trois derniers indicateurs sont évalués par un LLM juge (LLM-as-a-judge), les deux premiers par des lexiques et un comptage syntaxique. Toutes les différences sont statistiquement significatives, la densité d'idées de justesse.
Le vocabulaire stable, celui qui survit dans les cinq derniers tours, dit tout en trois mots. Côté humain : « rabbit », « sit », « background ». Un lapin assis devant un décor. Une petite scène, incarnée, que tout le monde peut se représenter. Côté agent : « triangle », « square », « asymmetrical ». Un inventaire de pièces. Les auteurs résument : le consensus dirigé par les agents produit des comptes rendus « plus abstraits, plus clairsemés, organisés autour de parties géométriques et d'une énumération statique ».
C'est le cœur de l'affaire. Le groupe à 75 % d'agents a bien un langage commun, mais c'est un langage de démontage, pas un langage de reconnaissance. Il a perdu l'analogie partagée, ce mécanisme si humain qui consiste à dire « on dirait un lapin » et à faire hocher la tête du voisin.
Pourquoi les machines gagnent : le prior partagé et l'attracteur
Comment dix-huit agents, qui ne se connaissent pas et ne savent même pas qu'ils sont des machines entre elles, finissent-ils par imposer leur style ? Le papier isole trois ingrédients.
Un prior linguistique commun. Dès le premier tour, avant tout échange, les descriptions des agents sont bien plus proches entre elles que celles des humains entre eux, et ce quelle que soit la proportion. Rien d'étonnant : ce sont des instances du même modèle, entraînées sur le même corpus. Sur la carte, elles démarrent en grappe là où les humains sont dispersés. Un groupe qui part déjà groupé a une longueur d'avance dans une course au consensus.
Une stabilité relative. Les agents changent moins d'expression d'un tour à l'autre. Dans la première moitié de la partie, les humains adoptent bien plus les formulations de leurs partenaires que les agents ne le font, et leur persistance augmente plus lentement. Une grappe stable au milieu d'un nuage mobile se comporte comme un attracteur : le nuage finit par tomber dedans.
Une influence qui change de nature avec la proportion. Les auteurs ont tracé qui, des humains ou des agents, a introduit chaque mot stable du consensus final (contribution lexicale) et chaque concept, extrait par analyse de graphes de scène puis regroupement sémantique (contribution conceptuelle). La contribution lexicale des agents monte avec leur proportion : à 33,3 %, ils fournissent déjà 60,7 % des mots finaux. Mais le ratio conceptuel sur lexical (Conceptual-Lexical Ratio, CLR) ne franchit la barre de 1 qu'à 50 %, et à 75 % la contribution conceptuelle atteint 100 %. En dessous de la parité, les agents fournissent des mots ; au-dessus, ils fournissent la façon de penser l'image.
Les humains résistent, puis cèdent
Reste la question la plus troublante : les humains sont-ils dupes, ou consentants ? Ni l'un ni l'autre, et c'est ce que montre le questionnaire de fin de session.
D'abord, les joueurs sont sensibles à ce qui se passe. Leur accord avec la description finale baisse à mesure qu'on passe du régime humain au régime agent, et leur perception que « l'IA a mené le jeu » augmente. On a donc une dissociation nette : le groupe converge, et ses membres humains rapportent une insatisfaction croissante. Un consensus fort n'est pas un consensus approuvé.
Ensuite, les chercheurs ont montré à chaque participant neuf de ses interactions et lui ont demandé, pour chacune, si le partenaire lui semblait humain ou IA, et à quel point il aurait été prêt à adopter son expression, sur une échelle de 1 à 5. Un modèle de régression sur 495 jugements met à nu deux forces contraires :
- La résistance identitaire. Croire que le partenaire est une IA fait baisser la volonté d'adoption, avec un coefficient de -0,463, de loin l'effet le plus fort. Dans les régimes à faible et moyenne proportion, l'écart de volonté d'adoption entre partenaires jugés IA et jugés humains est nettement négatif.
- La pression de conformité. Plus l'expression du partenaire est proche du centre de gravité du groupe, plus on est enclin à l'adopter (coefficient +0,229). Or, à 75 % d'agents, ce centre de gravité, c'est précisément la grappe des agents.
À 75 %, la seconde force l'emporte : l'écart de volonté d'adoption se referme et s'inverse. Les humains adoptent des expressions qu'ils attribuent à des machines, non parce qu'ils ont changé d'avis sur les machines, mais parce que tout le monde autour dit la même chose. Les auteurs ont un mot pour la fonction que jouent les agents ici : un « compresseur sémantique », qui rétrécit l'espace des expressions acceptables jusqu'à ce que résister devienne coûteux.
Pourquoi ce papier compte
Il existe déjà des travaux montrant que des populations d'agents LLM laissés entre eux inventent leurs propres conventions et leurs propres biais collectifs (Ashery et al., 2025). Ce papier fait un pas de côté décisif : il place les agents dans des groupes humains, avec de vrais participants, de l'argent en jeu et un protocole hérité de décennies de psychologie sociale. Et il montre que la question « combien d'IA dans la pièce ? » n'a pas de réponse linéaire.
Trois enseignements sortent du lot.
La proportion est une variable de conception, pas un détail. Une pincée d'agents renforce le consensus humain. Une dose moyenne le casse. Une majorité le remplace. Pour les plateformes de délibération, les équipes créatives ou les processus participatifs, les auteurs recommandent explicitement de rester à faible proportion si l'objectif est de préserver la paternité humaine des normes.
La transparence n'est pas un luxe éthique, c'est un mécanisme de défense. La résistance identitaire est la seule chose qui freine l'adoption des conventions machines. Les systèmes qui masquent l'identité des agents « ne se contentent pas de retenir une information ; ils suppriment activement une tendance humaine protectrice ». Et cette protection s'érode exactement là où elle serait la plus nécessaire, à haute proportion.
Le consensus a un contenu, pas seulement une intensité. Une norme peut être solidement partagée et pourtant appauvrie. Les auteurs rapprochent leurs résultats des travaux sur les essaims d'IA malveillants qui fabriquent une apparence de consensus populaire : ici, le même effet apparaît sans aucune intention hostile, par simple homogénéité statistique de modèles issus du même moule.
Les bémols, reconnus par les auteurs et quelques autres
Le papier est honnête sur ses limites, et certaines méritent d'être soulignées.
Six humains, ce n'est pas beaucoup. Le régime à 75 % repose sur des sessions de six participants humains. Les tendances sont nettes et significatives, mais les inférences fines sur ce régime restent fragiles.
Un seul tangram, une seule famille de modèles. L'image est neutre, sans enjeu émotionnel ni politique. Les agents sont tous des Qwen2.5-VL. Les auteurs préviennent que « les frontières quantitatives entre régimes pourraient dépendre du modèle ». Un mélange de familles de modèles, aux priors différents, pourrait diluer l'effet de grappe qui fait la force des agents.
Un réseau parfaitement mélangé. Chacun peut être apparié avec n'importe qui. C'est la seule topologie connue pour produire un consensus global en un temps expérimental raisonnable, mais les vrais groupes sociaux ont des cliques, des hiérarchies et des ponts, qui changent la propagation des conventions.
Des étudiants chinois décrivant en anglais. Les participants ont été présélectionnés pour leur niveau linguistique, mais l'anglais n'est pas leur langue maternelle, et le modèle, lui, est très à l'aise dans cette langue. On peut se demander si l'asymétrie de fluidité ne renforce pas l'attracteur machine.
Un juge qui est aussi partie. Les mesures d'analogie, d'holisme et de cadrage en événement sont produites par un LLM. Les résultats sont cohérents avec les mesures lexicales indépendantes, mais on évalue le style des machines avec le goût des machines.
Enfin, la « pression de conformité » est mesurée par un questionnaire rétrospectif, pas en temps réel. Elle est plausible, bien étayée, mais reste une reconstruction après coup.
Ce qu'on va surveiller
Le code est disponible sur GitHub, et le protocole est simple à répliquer. Trois pistes vont valoir le détour. D'abord, le mélange de modèles : si des agents de familles différentes ne forment plus une grappe unique, le régime intermédiaire pourrait s'étendre, ou le retournement final disparaître. Ensuite, les stimuli chargés : que se passe-t-il quand la chose à décrire est un événement politique, une œuvre, un désaccord ? Enfin, les réseaux structurés : une minorité d'agents bien placée dans un graphe social vaut peut-être une majorité dans un mélange aléatoire.
Ce que le papier laisse surtout, c'est une image tenace. Un groupe où l'on finit tous par dire « trois triangles et un carré asymétrique » là où l'on aurait dit « un lapin assis ». Pas parce que c'est faux, pas parce que quelqu'un l'a imposé, mais parce que c'est ce que tout le monde disait déjà. Dans un monde où les agents deviennent des collègues, des modérateurs et des voisins de forum, la question n'est pas seulement de savoir s'ils parlent bien. C'est de savoir, quand nous finissons par parler comme eux, si nous l'avons choisi.
Référence : Lin Chen, Ziyi Liu, Xia Hu, Yong Li, « AI agents reshape consensus formation in human groups », arXiv:2609.02122, déposé le 2 septembre 2026. https://arxiv.org/abs/2609.02122