Two Centuries of Sexism in British Parliament — Sexisme ambivalent : deux siècles de Parlement britannique passés au crible d'un LLM
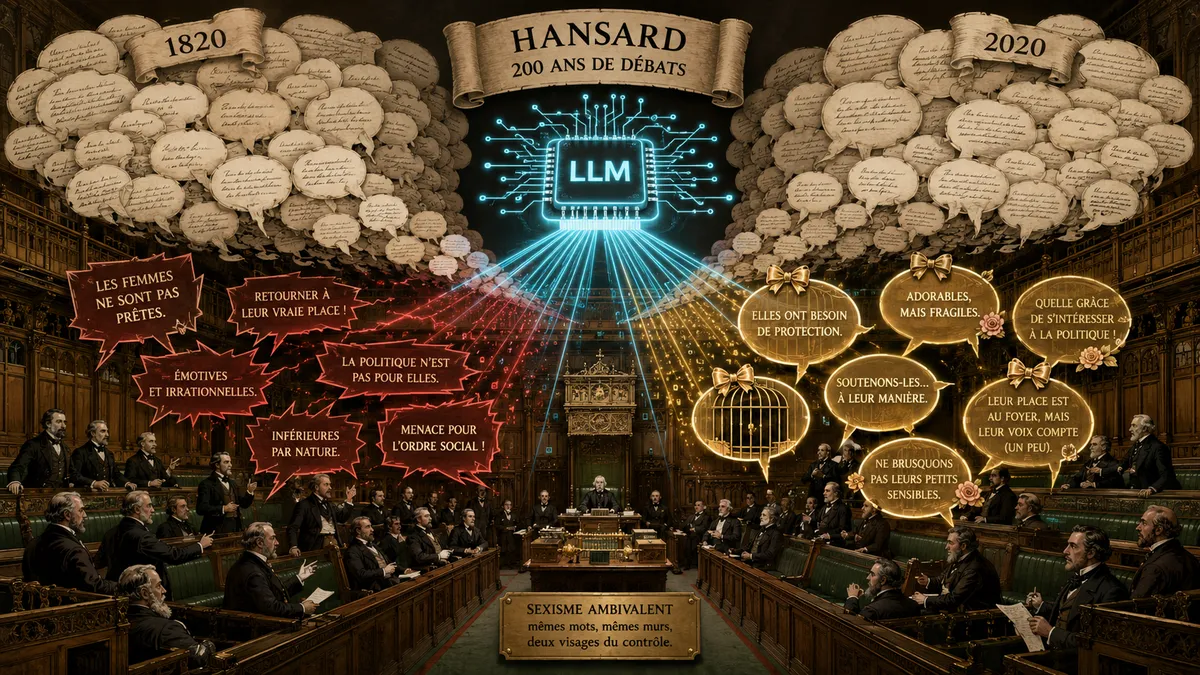
Westminster, 1897. Sir Barrington Simeon monte à la tribune et lâche, très sérieusement, que « si jamais les femmes entraient au Parlement, la fin de ce pays ne serait pas bien loin ». Trente ans plus tôt, en 1867, Sir George Bowyer soutenait lui le vote des femmes, mais en expliquant que le vote par correspondance « permettrait au sexe [féminin] de voter d'une manière exempte de toute objection ». Comprendre : sans se salir au contact des bureaux de vote, ces endroits si peu convenables pour une dame.
Deux discours, deux camps opposés, et pourtant un même fond de teint idéologique. C'est exactement ce paradoxe qu'une équipe de chercheurs vient de quantifier à l'échelle de deux siècles, dans un papier accepté à EMNLP 2026 : Two Centuries of Sexism in British Parliament: A Computational Analysis of Women's Representation in the Hansard Corpus, de Mohammad Omar Khursheed, Mandira Sawkar et Ashiqur R. KhudaBukhsh, déposé sur arXiv le 31 août 2026. Leur constat, chiffres à l'appui : même les discours qui défendaient les droits des femmes étaient truffés de sexisme. Mais pas le même sexisme que celui de l'autre camp.
Hansard, la boîte noire verbatim du Parlement britannique
Le matériau de départ est un monument : le Hansard, compte rendu quasi officiel des débats du Parlement britannique, qui consigne mot pour mot qui a dit quoi depuis 1803. Imaginez une boîte noire d'avion, mais pour une démocratie : deux siècles de conversations politiques enregistrées, disponibles publiquement.
Le problème, c'est que ce trésor est livré brut de décoffrage. Les auteurs ont donc d'abord fait un travail de plomberie de données considérable : ils publient une version réorganisée et enrichie du corpus, soit 6,7 millions de discours répartis dans 1,2 million de débats entre 1803 et 2005. Surtout, ils ont apparié chaque orateur à son genre via un pipeline en cascade : titres ministériels, registres de circonscriptions, recoupements temporels et fuzzy string matching (appariement approximatif de chaînes de caractères, pour rattraper les « M. Churchil » et autres coquilles de sténographes). Résultat : 89,3 % des discours de la Chambre des communes sont rattachés à un orateur genré. La Chambre des lords, elle, plafonne à 1,2 % d'appariement (les lords adorent les titres qui brouillent les pistes) et a donc été écartée de l'analyse. Le tout est publié sous licence CC BY 4.0 : un outil réutilisable pour quiconque fait des sciences sociales computationnelles.
Dans cette meule de foin de 6,7 millions de discours, restait à trouver les aiguilles. Les auteurs ont procédé par mots-clés en deux paliers : un premier filet à mailles fines (termes explicites comme women's suffrage, votes for women, suffragette : 2 725 discours), puis un filet plus large (les mots women ou female à moins de 25 mots de termes électoraux comme vote ou franchise : 3 806 discours). Total : 6 531 discours candidats, dont un LLM a ensuite écarté 55 % de faux positifs, des débats où « femmes » et « vote » cohabitaient par hasard. Restent 2 942 discours réellement consacrés aux droits politiques des femmes.
Le sexisme ambivalent, ou la carotte et le bâton
Avant de parler machines, un détour par la psychologie sociale s'impose, car tout le papier repose sur une théorie de 1996 : le sexisme ambivalent de Glick et Fiske, opérationnalisé dans leur Ambivalent Sexism Inventory (inventaire du sexisme ambivalent). L'idée centrale : le sexisme ne se résume pas à l'hostilité. Il fonctionne comme un système à deux faces complémentaires.
Le sexisme hostile (hostile sexism), c'est le bâton : les femmes sont incompétentes, manipulatrices, doivent être tenues sous autorité masculine. Le sexisme bienveillant (benevolent sexism), c'est la carotte : les femmes sont pures, tendres, moralement supérieures, et méritent d'être protégées, chéries… et cantonnées au foyer. Le second est plus sournois, parce qu'il ressemble à un compliment. Dire « une femme a une tendresse que certains hommes n'ont pas » (citation authentique du révérend Ian Paisley aux Communes… en 1992), c'est enfermer dans une cage dorée tout en ayant l'air galant. La théorie prédit que les deux formes se répartissent les rôles : l'hostilité punit les femmes qui contestent l'ordre établi, la bienveillance récompense celles qui s'y conforment.
Jusqu'ici, cette théorie avait surtout été testée par questionnaires sur des sujets contemporains. Le coup de génie du papier est de la confronter à deux siècles de discours réels, prononcés par des gens qui ignoraient qu'on les analyserait un jour.
Un LLM dans le rôle de l'historien-annotateur
Comment classifier 6 531 discours victoriens sans y passer une carrière ? C'est ici que les grands modèles de langage entrent en scène, dans un rôle de plus en plus courant en sciences sociales : celui d'annotateur à l'échelle industrielle, ce qu'on appelle le LLM-as-a-judge (le LLM comme juge).
Le protocole est soigné. Chaque discours passe deux examens successifs. D'abord la position (stance) : pour, contre, mitigé ou hors sujet vis-à-vis de la représentation politique des femmes. Puis, pour les discours pertinents, la détection de sexisme selon les six sous-catégories de l'inventaire de Glick et Fiske (paternalisme dominateur ou protecteur, différenciation compétitive ou complémentaire, etc.). Le modèle reçoit jusqu'à cinq discours avant et après pour saisir le contexte du débat, indispensable quand un orateur répond par une pique à un collègue, et répond dans un format JSON strict.
Mais peut-on faire confiance à la machine sur du matériau aussi piégeux ? Les auteurs ont construit un étalon humain : 300 discours annotés indépendamment par deux personnes (un homme, une femme), environ 40 heures de travail chacune, avec un accord inter-annotateurs modéré (kappa de Cohen κ = 0,644, une mesure d'accord qui corrige le hasard, où 1 serait l'unanimité parfaite). Les 106 désaccords ont été tranchés par discussion. Verdict : le classifieur principal, Claude Sonnet 4.6, atteint κ = 0,711 contre ce consensus humain sur la position, soit un accord meilleur que celui des deux humains entre eux. GPT-5 suit de près (0,692), DeepSeek V3 et Gemini 2.5 Flash ferment la marche. Sur la détection du sexisme, en revanche, tout le monde souffre : κ = 0,543 pour l'hostile, 0,463 pour le bienveillant. Les auteurs le reconnaissent sans détour : annoter le sexisme dans des textes historiques est authentiquement difficile, y compris pour les humains.
Ce que racontent les chiffres : deux sexismes pour deux stratégies
Sur les 2 942 discours pertinents : 74 % soutiennent les droits politiques des femmes, 19 % s'y opposent, 7 % sont mitigés. Premier enseignement contre-intuitif : le Parlement était majoritairement favorable depuis longtemps (54 % de discours pro avant même 1870), et pourtant il a fallu attendre 1918 (vote partiel) puis 1928 (égalité électorale). Une minorité opposante a tenu la ligne pendant des décennies : preuve qu'au Parlement, gagner le débat et gagner le vote sont deux sports différents.
Deuxième enseignement, le cœur du papier : 54 % des discours anti-suffrage contiennent du contenu sexiste, contre 21 % des discours pro. Mais la vraie découverte est qualitative. Chez les opposants, le sexisme est un cocktail : 37 % d'hostile pur, 19 % de bienveillant pur, et 44 % qui mélangent les deux, le bâton et la carotte dans le même discours, comme ce M. Labouchere qui en 1894 jugeait le vote des femmes « destructeur de tous les charmes de la domesticité ». Chez les partisans, en revanche, le sexisme est bienveillant à 81 %, l'hostile pur tombant à 2 %. Autrement dit : quand un allié de la cause dérapait, ce n'était presque jamais pour dénigrer les femmes, mais pour les statufier. Des anges du foyer qu'il fallait, justement parce qu'elles étaient si pures, laisser voter.
C'est exactement la répartition des rôles que prédit la théorie du sexisme ambivalent, observée cette fois in vivo sur 200 ans. Et la dynamique temporelle enfonce le clou : le sexisme hostile s'effondre (de 60 % des discours sexistes en 1870-1899 à moins de 30 % après 1929), tandis que le bienveillant, lui, persiste tranquillement à 74-83 % sur toute la période, jusqu'au « compliment » de Paisley en 1992. L'hostilité ouverte est devenue socialement coûteuse ; le paternalisme galant, jamais vraiment.
Dernier chiffre marquant : les femmes députées soutiennent les droits politiques des femmes à 93 %, contre 70 % pour leurs collègues masculins. L'écart reste significatif même en tenant compte de l'époque (rapport de cotes de 2,01) et ne se referme qu'après l'obtention du droit de vote, le soutien masculin grimpant à 91 % après 1950. Détail savoureux : les discours des femmes députées contiennent eux aussi du sexisme, à 21 %, presque exclusivement bienveillant. Le sexisme ambivalent n'est pas une affaire d'hommes : c'est un langage ambiant, que tout le monde parlait.
Pourquoi ce papier compte
Trois raisons, au moins.
D'abord, il valide une théorie de psychologie sociale sur des données historiques massives et écologiques. Les questionnaires mesurent ce que les gens acceptent de déclarer ; le Hansard enregistre ce qu'ils disaient réellement quand il y avait un enjeu. Voir la prédiction de Glick et Fiske (hostilité pour punir, bienveillance pour récompenser la conformité) émerger spontanément de deux siècles de rhétorique parlementaire, c'est un joli cas d'école de ce que les LLM apportent aux sciences sociales : changer l'échelle sans (trop) sacrifier la finesse.
Ensuite, le livrable dataset. Les 6,7 millions de discours enrichis en métadonnées, avec genre apparié à 89 %, sont publiés librement. C'est une infrastructure : les auteurs suggèrent eux-mêmes d'appliquer la même grille à d'autres débats sur des droits collectifs, comme le mariage pour tous ou les droits reproductifs. Toute controverse législative où une majorité « bienveillante » a fait traîner les choses est un terrain de jeu potentiel.
Enfin, la leçon dépasse l'histoire. Le sexisme bienveillant est précisément celui qui survit le mieux au temps. C'est aussi le plus dur à détecter, pour les humains comme pour les machines : les kappas les plus faibles du papier sont là, jusqu'au 0,246 de DeepSeek V3. Or c'est ce type de biais feutré qui imprègne les corpus d'entraînement de nos modèles actuels. Mesurer sa persistance historique, c'est aussi outiller sa détection contemporaine.
Les bémols, assumés par les auteurs
Le papier a l'élégance de lister ses propres failles. La sélection par mots-clés d'abord : elle rate forcément des débats qui parlaient des droits des femmes avec un autre vocabulaire, et le filtre LLM a dû écarter 55 % de faux positifs, signe que le filet était grossier. Ensuite, le juge principal reste un unique modèle propriétaire : la validation croisée avec trois autres LLM rassure (accords inter-modèles de 0,593 à 0,777), mais chaque modèle a ses biais, et sur le sexisme bienveillant, justement le concept central, l'accord est le plus fragile. La catégorie « position mitigée » est carrément sous-détectée (F1 de 0,22) : les nuances du type « oui au vote, non à l'éligibilité » passent mal. Ajoutez une couverture limitée aux Communes, un genre traité de façon binaire (limite que les auteurs reconnaissent explicitement), et un cadre assumé comme descriptif et non causal. Côté robustesse, un point rassurant : en injectant volontairement 3 % d'erreurs dans les étiquettes de genre sur 1 000 itérations, les résultats restent statistiquement significatifs. Le tableau est donc solide dans ses grandes lignes, pointilliste dans ses détails.
On ajoutera un bémol maison : κ = 0,711 contre un consensus humain lui-même modéré (0,644), cela signifie que la « vérité terrain » est floue. Le papier ne mesure pas le sexisme, mais un sexisme tel qu'opérationnalisé par une grille de 1996 et interprété par des annotateurs de 2026. C'est inévitable, et honnêtement documenté, mais à garder en tête avant de citer « 54 % » comme un fait de nature.
Et maintenant ?
Ce qu'on surveillera : les réutilisations du corpus. Un Hansard propre, genré et daté sur deux siècles, c'est le genre de ressource qui engendre dix papiers par an. Attendez-vous à voir fleurir des analyses sur le débat colonial, l'immigration ou les droits sociaux avec la même mécanique stance + taxonomie psychosociale. On guettera aussi les répliques sur d'autres parlements (l'Assemblée nationale française a ses propres archives verbatim…) et les progrès des modèles sur la détection du sexisme bienveillant, qui reste le maillon faible mesurable de toute cette chaîne.
Et puis il y a la question qui pique : si un LLM sait désormais repérer, dans un discours de 1867, le compliment qui enferme, saura-t-on s'en servir pour l'entendre dans les discours de 2026 ? Le Hansard continue de tourner, lui. La boîte noire enregistre toujours.
Référence : Mohammad Omar Khursheed, Mandira Sawkar et Ashiqur R. KhudaBukhsh, « Two Centuries of Sexism in British Parliament: A Computational Analysis of Women's Representation in the Hansard Corpus », arXiv:2608.30485, déposé le 31 août 2026, accepté à EMNLP 2026 (Main Conference). Abstract sur arXiv.