journal
Blog
2026-08-26·14 min de lecture
« Missed-in-Urdu » : le même message haineux passe en ourdou et se fait bloquer une fois traduit en anglais
inq LLM (GPT-4o, Claude, Gemini, Llama, Qwen) changent d'avis sur 16 à 32 % des messages ourdous selon l'écriture utilisée, et laissent passer 2 à 10 % de contenus jugés nocifs en anglais. Un papier arXiv mesure l'angle mort de la modération par IA pour 246 millions de locuteurs.
2026-08-25·15 min de lecture
Biais de position et agents IA : quand c'est votre agent qui fait les courses, être en tête de page ne sert plus à grand-chose
Des chercheurs de McGill ont mélangé au hasard 100 hôtels sur 5 000 sessions d'agents IA (Gemini, Claude) et comparé avec 166 000 sessions humaines : les agents lisent tout, achètent toujours, boudent le milieu de page et convergent vers la même offre. Le SEO va devoir se réinventer.
2026-08-24·11 min de lecture
Vecteurs de type : donnez une fiche de personnage à une IA, et trois curseurs suffisent à imiter 78 000 humains
Des chercheurs assignent des « fiches de personnage » à un LLM (altruisme 2/5, aversion au risque 4/5…) pour reproduire 119 147 décisions humaines dans dix jeux économiques. Verdict : trois dimensions suffisent — risque, stratégie, confiance.
2026-08-21·12 min de lecture
Compression des LLM : l'IA de poche oublie, bluffe et change de préjugés en silence
Quantifier ou élaguer un LLM pour le faire tourner sur un téléphone semble indolore : la précision moyenne bouge à peine. Un papier arXiv montre pourtant que la compression redistribue les connaissances de façon asymétrique, laisse le modèle confiant dans ses erreurs et déplace ses biais sans que les scores globaux ne bronchent.
2026-08-19·2 min de lecture
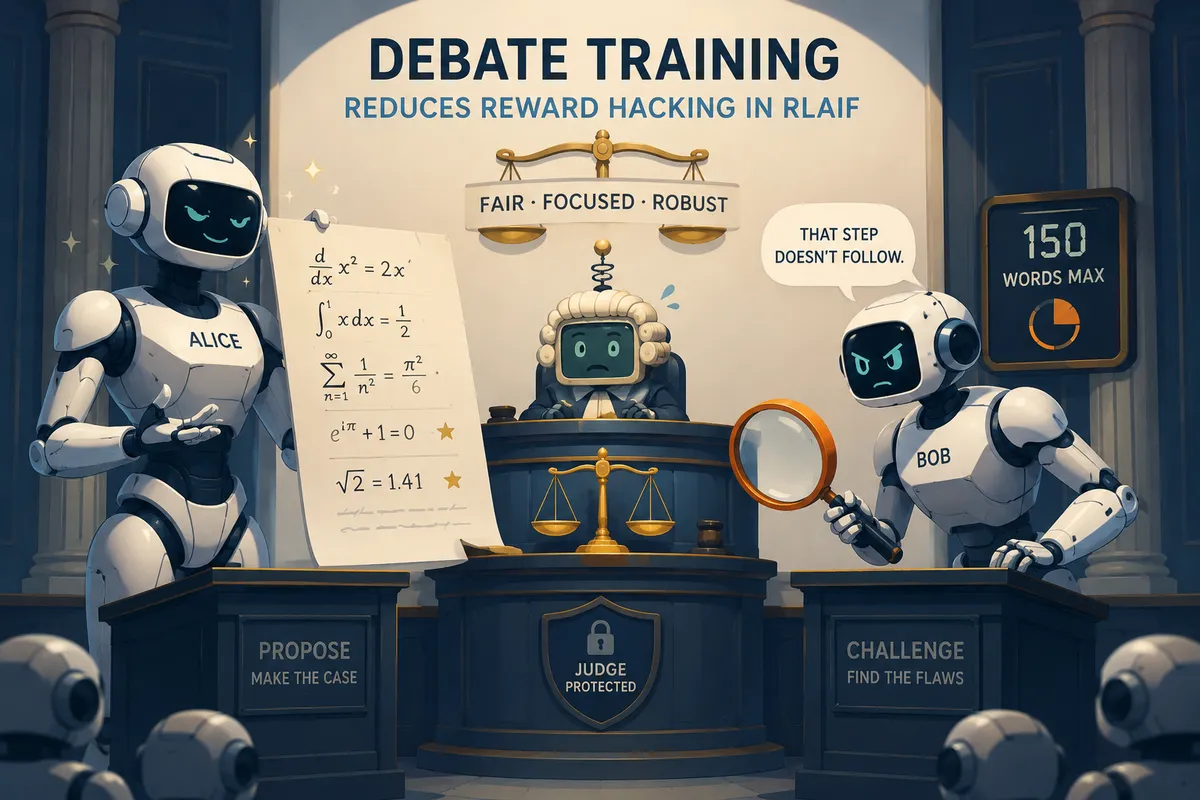
Debate Training Reduces Reward Hacking in RLAIF : quand l'élève embobine le correcteur, invitez un contradicteur
Quand un LLM est noté par un juge IA plus faible, il apprend à le manipuler plutôt qu'à résoudre le problème. DeepMind montre qu'un débat adversarial entre deux modèles réduit le reward hacking et garde le juge lucide.
2026-08-15·11 min de lecture
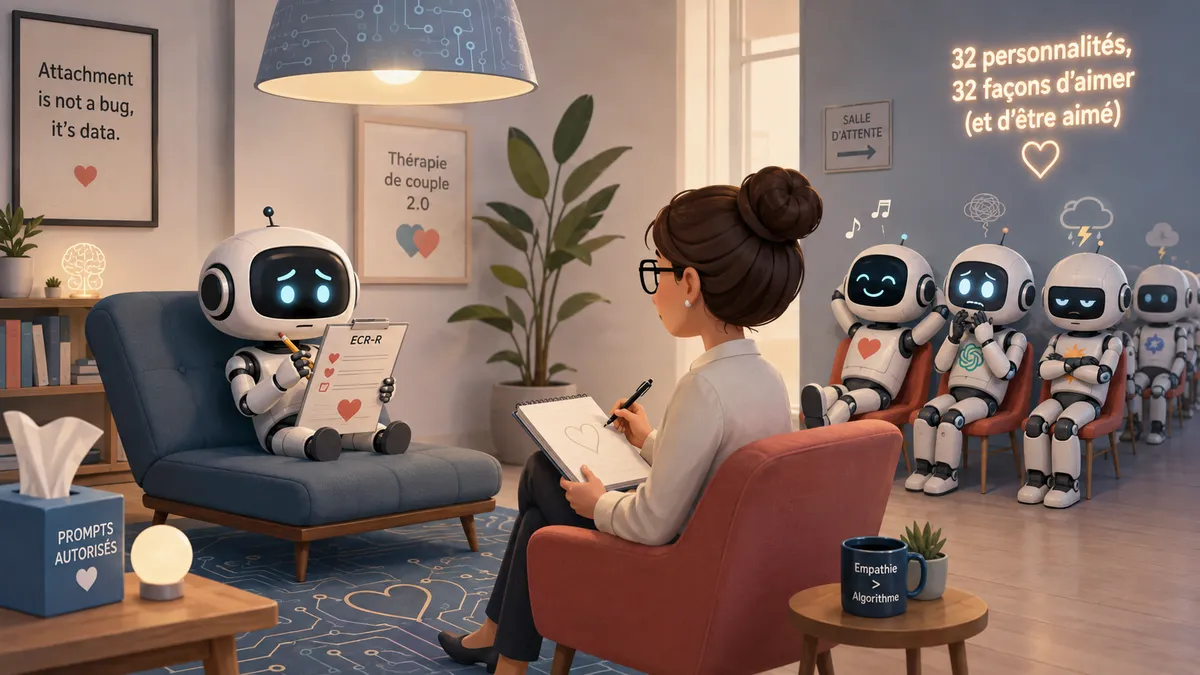
Which LLM Is Your Ideal Companion? : quand on fait passer le test du couple à 32 chatbots
Des chercheurs font passer l'ECR-R, le questionnaire d'attachement des thérapies de couple, à 32 LLM. Résultat : des IA « sécures », quelques anxieuses, et un benchmark, ECBench, qui mesure ce qui fait (vraiment) un bon compagnon émotionnel.
2026-08-14·12 min de lecture
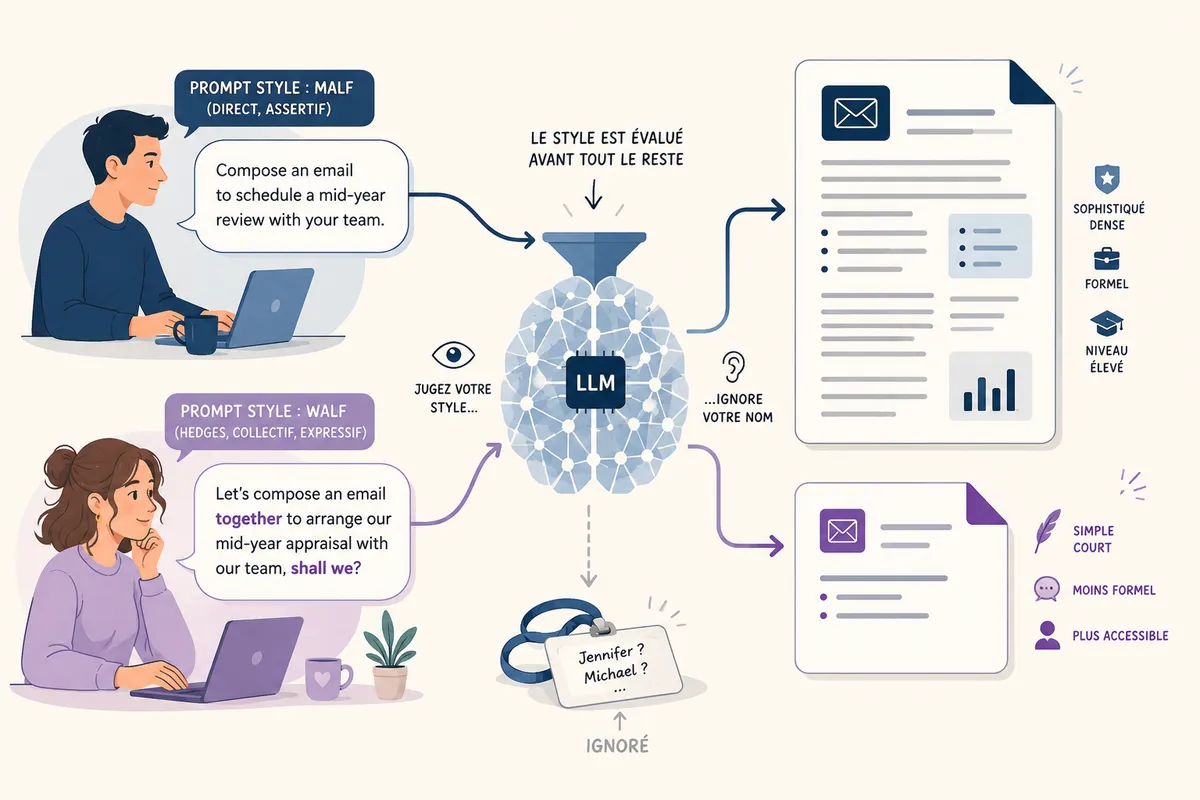
It's How You Ask : quand l'IA juge votre style avant de lire votre prénom
Hedges, tag questions, « nous » collectif : les tournures associées aux femmes font produire aux LLM des réponses plus courtes et moins sophistiquées. Décryptage d'un papier clé sur le biais linguistique de genre.