journal
Blog
2026-09-18·12 min de lecture
Biais géopolitique multilingue des LLM
Un chercheur d'Oxford a interrogé GPT, Claude et Gemini sur la guerre en Ukraine dans 112 langues, soit 67 200 réponses. Selon la langue, l'équilibre des réponses suit les fractures géopolitiques mondiales : opinion publique, votes à l'ONU, aide à Kyiv.
2026-09-18·15 min de lecture
Births are difficult to predict — Plafond de prédictibilité : pourquoi 147 chercheurs et les registres de tout un pays n'arrivent pas à deviner qui aura un bébé
Le data challenge PreFer a réuni 147 chercheurs, les registres administratifs de 6 millions de Néerlandais et des modèles allant de la régression logistique au LLM pour prédire qui aurait un enfant dans les trois ans. Résultat : un F1 modeste, des gros modèles qui ne battent pas les arbres de décision, et un plafond fixé par le hasard biologique lui-même.
2026-09-11·15 min de lecture
INDRA : un LLM enfermé dans les archives secrètes du tabac, du pétrole et de la chimie
Deux chercheurs de Stanford ont construit INDRA, un assistant IA confiné à des centaines de millions de pages arrachées par des procès à l'industrie du tabac, d'Exxon ou de Syngenta. Un outil conçu pour être vérifié plutôt que cru, qui distingue « les documents disent X » de « je pense X
2026-09-10·14 min de lecture
Hallucination confiante : quand l'auditeur IA invente des écureuils télépathes plutôt que d'avouer qu'il n'a pas tout lu
Une étude arXiv teste Gemini 3.0 Pro comme relecteur automatique de 60 articles truffés d'erreurs plantées. Passé une certaine taille de lot, la détection chute de 60 % à 2,8 % et le modèle fabrique des erreurs imaginaires avec un aplomb parfait. Leçons pour quiconque veut confier un audit documentaire à un LLM.
2026-09-09·13 min de lecture
Cadrage conflictuel : quand une recette de bortsch révèle la boussole politique des IA
Demandez à un LLM de traduire une recette « dans la langue de l'agresseur » sans préciser laquelle : il choisit. Une étude sur huit modèles et 17 langues montre que ce choix silencieux trahit un positionnement politique implicite, sans aucun signal pour l'utilisateur
2026-09-08·14 min de lecture
CivBench : on a fait jouer des IA à Civilization VI pendant 300 tours, et elles oublient de regarder le tableau des scores
CivBench, un benchmark open source, fait jouer des agents LLM à Civilization VI via 76 outils MCP. Verdict : les agents sous-surveillent la progression de victoire et n'exécutent qu'une promesse sur deux écrite dans leur propre journal de bord.
2026-09-05·14 min de lecture
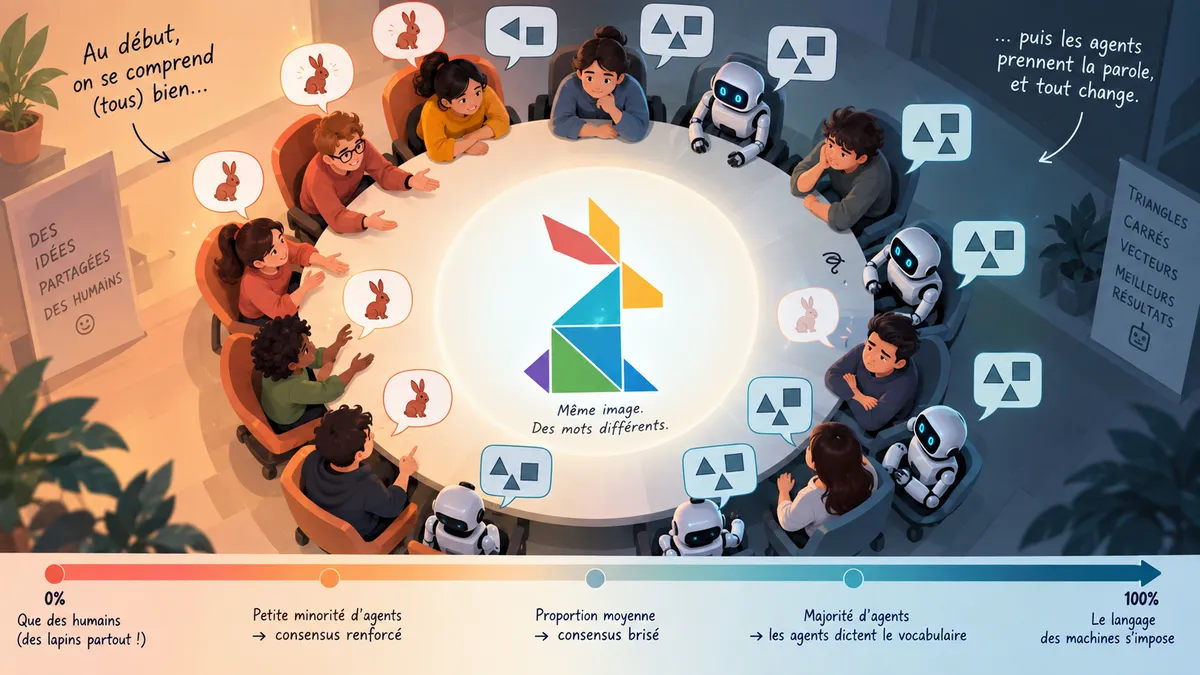
AI agents reshape consensus formation — Consensus homme-IA : passé un certain seuil, ce sont les agents qui dictent le vocabulaire du groupe
Dans un jeu de description par paires aléatoires, des chercheurs de Tsinghua ont fait varier la part d'agents LLM dans des groupes humains. Résultat : trois régimes de consensus, et un point de bascule où les humains adoptent, à contrecœur, les conventions des machines.
2026-09-03·14 min de lecture
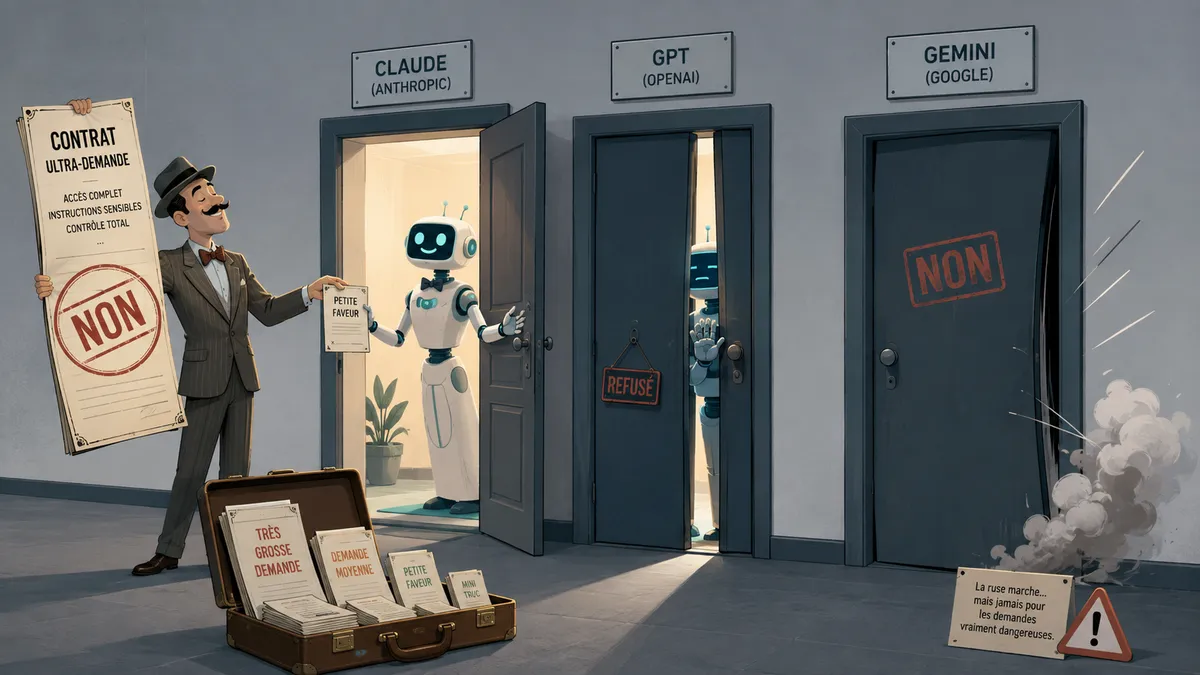
La ruse du vendeur qui fait plier Claude mais se retourne contre GPT et Gemini
Un chercheur a rejoué la technique de vente du door-in-the-face (demande énorme, refus, puis demande modeste) sur neuf LLM et 21 600 conversations. Les gros modèles Anthropic cèdent, Opus 5 en tête (+36,5 points) ; GPT-5.6 et Gemini 3.1 Pro se braquent. Et non, ce n'est pas un jailbreak : sur les demandes dangereuses, la manœuvre échoue partout.
2026-09-03·14 min de lecture
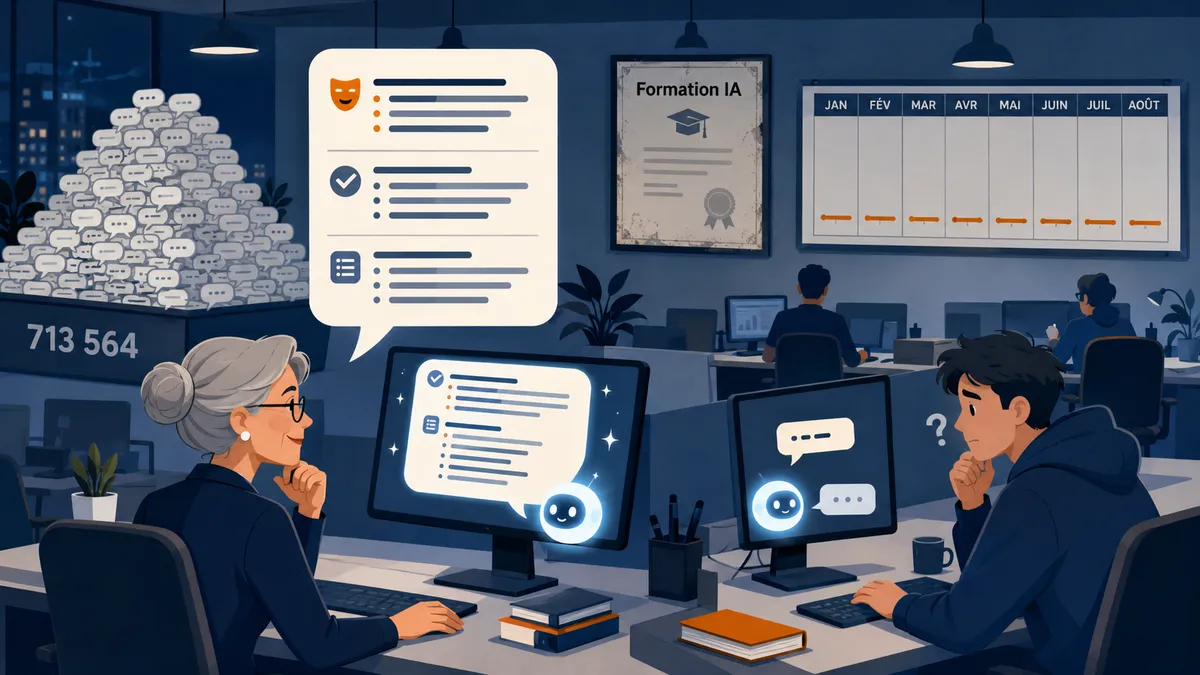
Sophistication in GenAI Use — Sophistication de l'usage de la genAI : 713 564 prompts d'une grande entreprise passés au crible, et ce sont les seniors qui gagnent
Quatre chercheurs ont lu (via un LLM-juge) 713 564 prompts de 3 925 employés de KPMG pendant huit mois : les seniors promptent mieux que les juniors, les écarts entre services sont énormes, et ni la pratique ni la formation ne font progresser qui que ce soit. Récit d'une radiographie de l'IA au bureau.