journal
Blog
2026-09-01·11 min de lecture
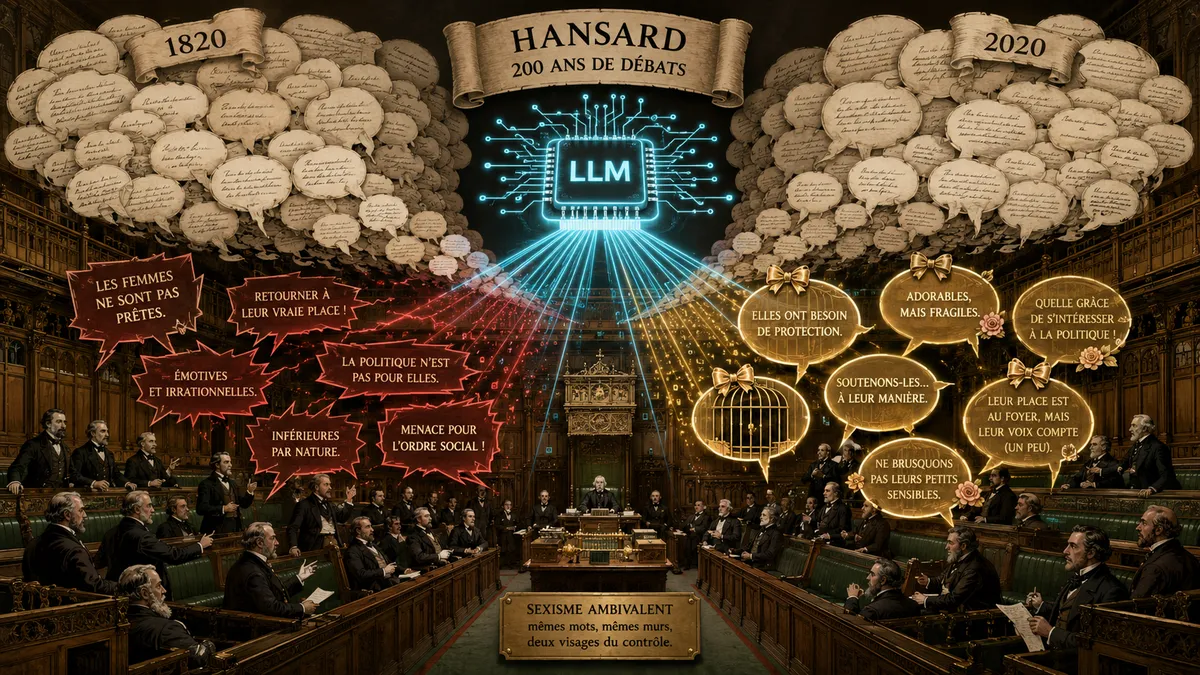
Two Centuries of Sexism in British Parliament — Sexisme ambivalent : deux siècles de Parlement britannique passés au crible d'un LLM
Des chercheurs ont analysé 200 ans de débats du Hansard avec des LLM : 54 % des discours anti-suffrage contiennent du sexisme… mais 21 % des discours pro aussi, presque toujours sous forme « bienveillante ». Récit d'une radiographie historique.
2026-08-28·13 min de lecture
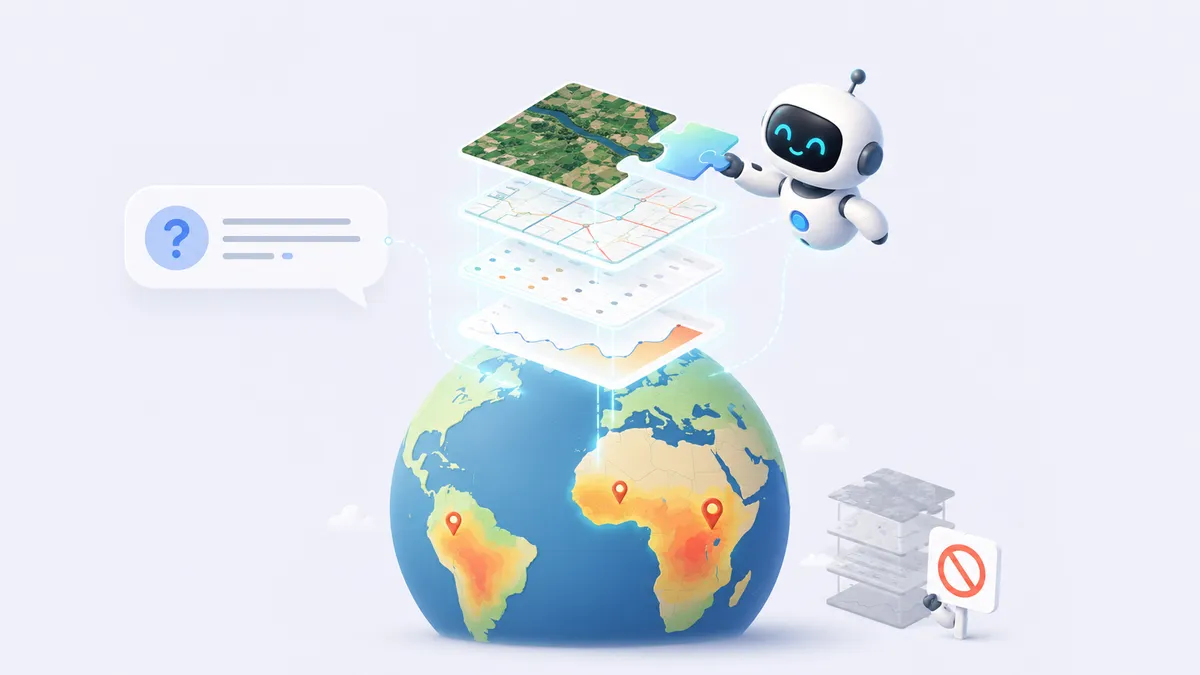
Planetary Prediction Engine : un agent IA qui assemble seul satellites et statistiques publiques pour prédire famines, vulnérabilités et foyers d’Ebola
Le Planetary Prediction Engine de Google transforme une question en langage naturel en pipeline géospatial complet : sélection des données, embeddings de modèles de fondation, choix du modèle. Résultat : de meilleures prédictions que les experts sur la santé aux États-Unis, l'insécurité alimentaire au Nigeria et l'épidémie d'Ebola 2026 en RDC.
2026-08-27·13 min de lecture
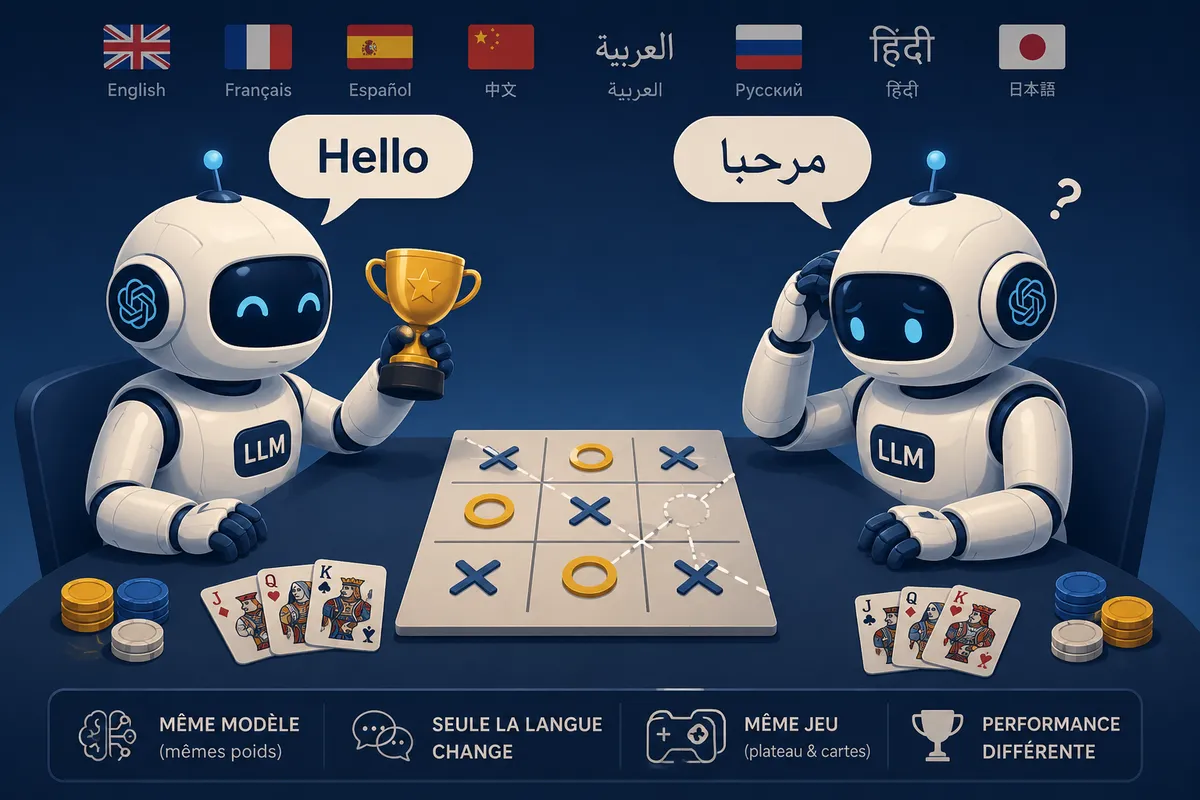
Self-play multilingue : quand un LLM joue contre lui-même, la langue décide qui gagne
Deux clones du même modèle s'affrontent à Nim, au poker ou au morpion, chacun dans une langue différente : l'anglais gagne, l'hébreu perd. Un papier arXiv montre que les compétences des LLM, pas seulement leurs connaissances, dépendent de la langue.
2026-08-26·14 min de lecture
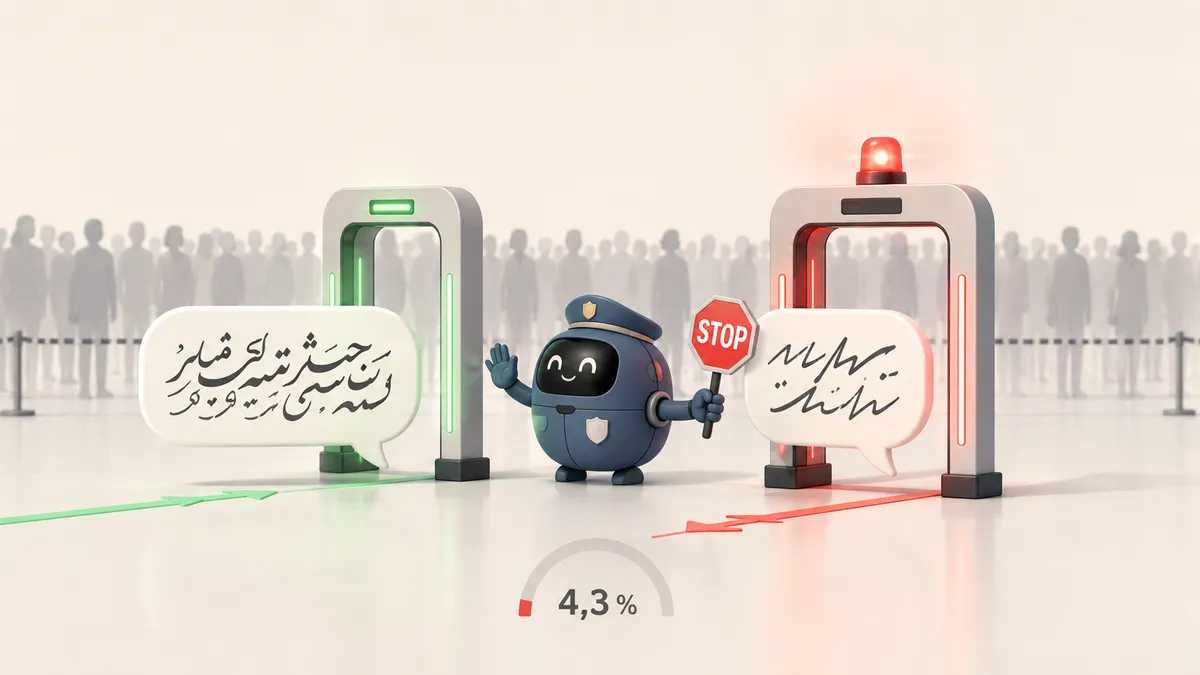
« Missed-in-Urdu » : le même message haineux passe en ourdou et se fait bloquer une fois traduit en anglais
inq LLM (GPT-4o, Claude, Gemini, Llama, Qwen) changent d'avis sur 16 à 32 % des messages ourdous selon l'écriture utilisée, et laissent passer 2 à 10 % de contenus jugés nocifs en anglais. Un papier arXiv mesure l'angle mort de la modération par IA pour 246 millions de locuteurs.
2026-08-25·15 min de lecture
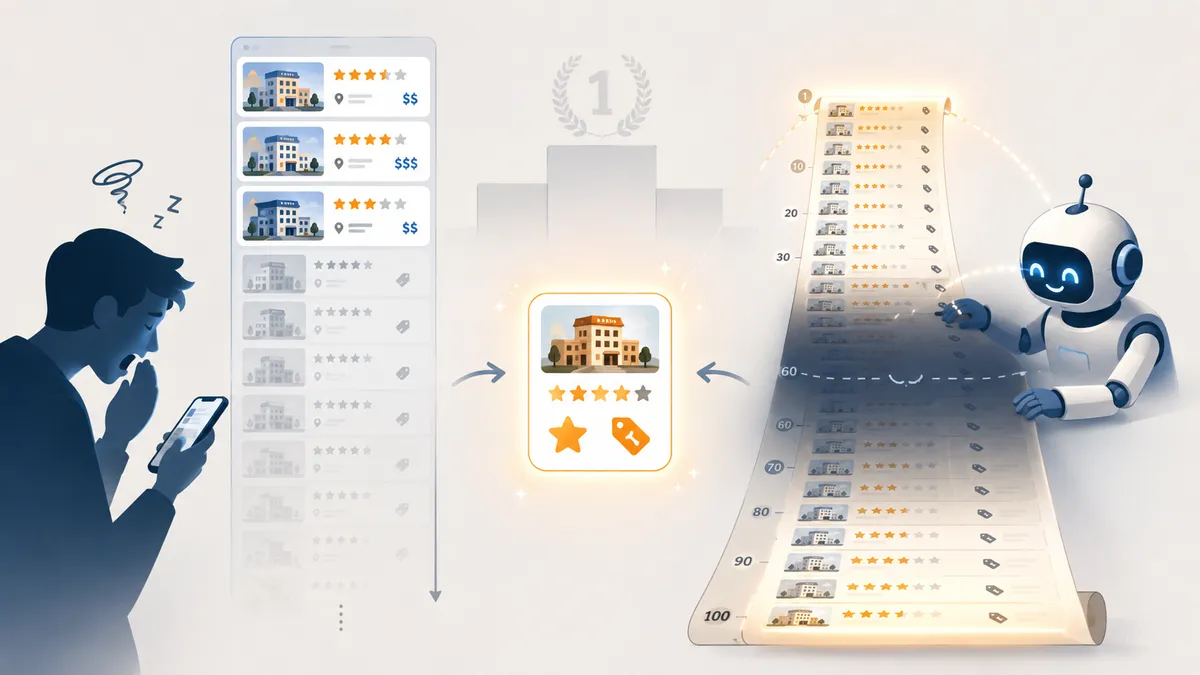
Biais de position et agents IA : quand c'est votre agent qui fait les courses, être en tête de page ne sert plus à grand-chose
Des chercheurs de McGill ont mélangé au hasard 100 hôtels sur 5 000 sessions d'agents IA (Gemini, Claude) et comparé avec 166 000 sessions humaines : les agents lisent tout, achètent toujours, boudent le milieu de page et convergent vers la même offre. Le SEO va devoir se réinventer.
2026-08-24·11 min de lecture
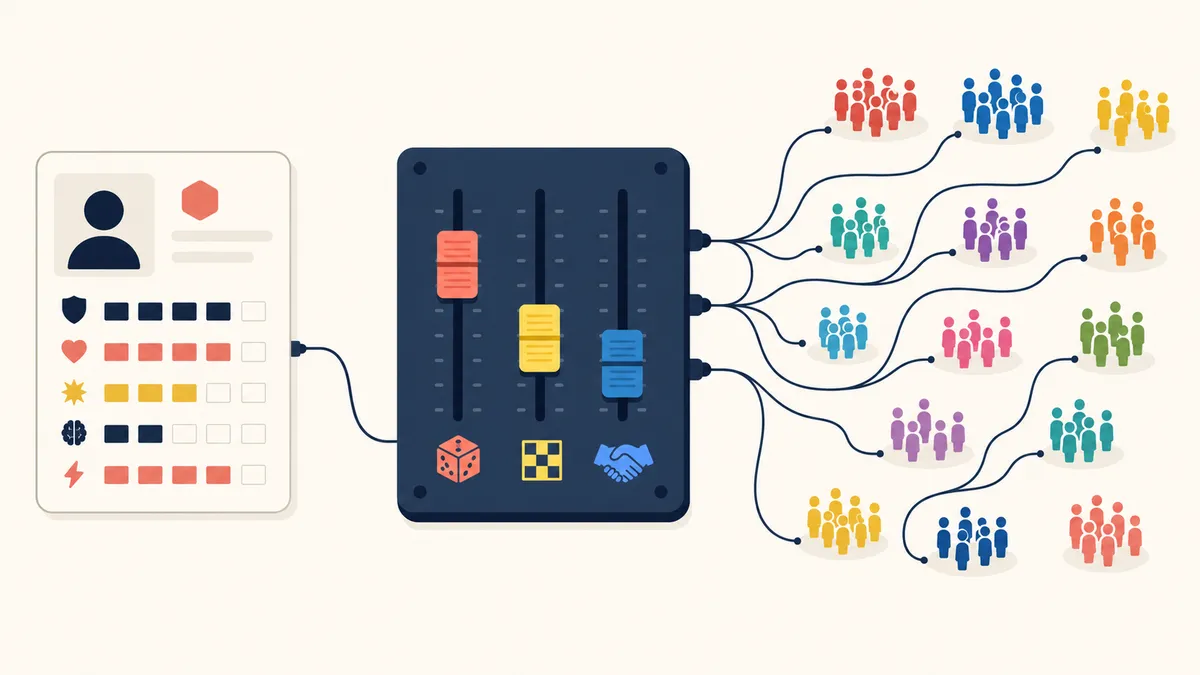
Vecteurs de type : donnez une fiche de personnage à une IA, et trois curseurs suffisent à imiter 78 000 humains
Des chercheurs assignent des « fiches de personnage » à un LLM (altruisme 2/5, aversion au risque 4/5…) pour reproduire 119 147 décisions humaines dans dix jeux économiques. Verdict : trois dimensions suffisent — risque, stratégie, confiance.
2026-08-21·12 min de lecture
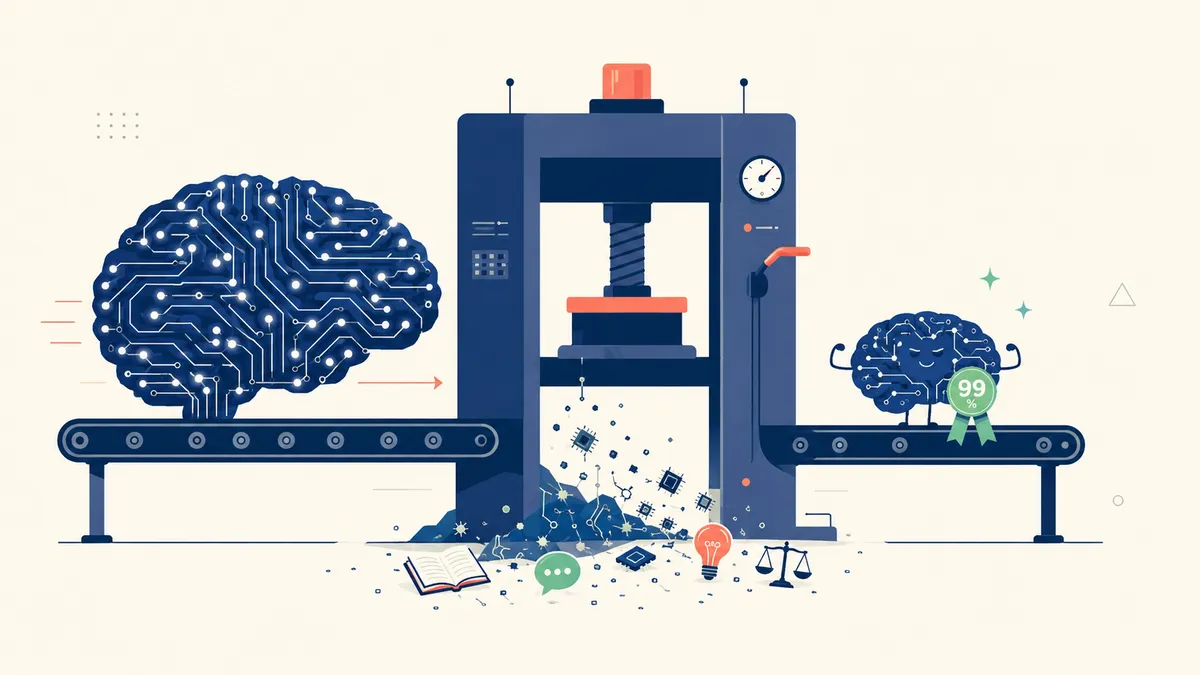
Compression des LLM : l'IA de poche oublie, bluffe et change de préjugés en silence
Quantifier ou élaguer un LLM pour le faire tourner sur un téléphone semble indolore : la précision moyenne bouge à peine. Un papier arXiv montre pourtant que la compression redistribue les connaissances de façon asymétrique, laisse le modèle confiant dans ses erreurs et déplace ses biais sans que les scores globaux ne bronchent.
2026-08-20·11 min de lecture
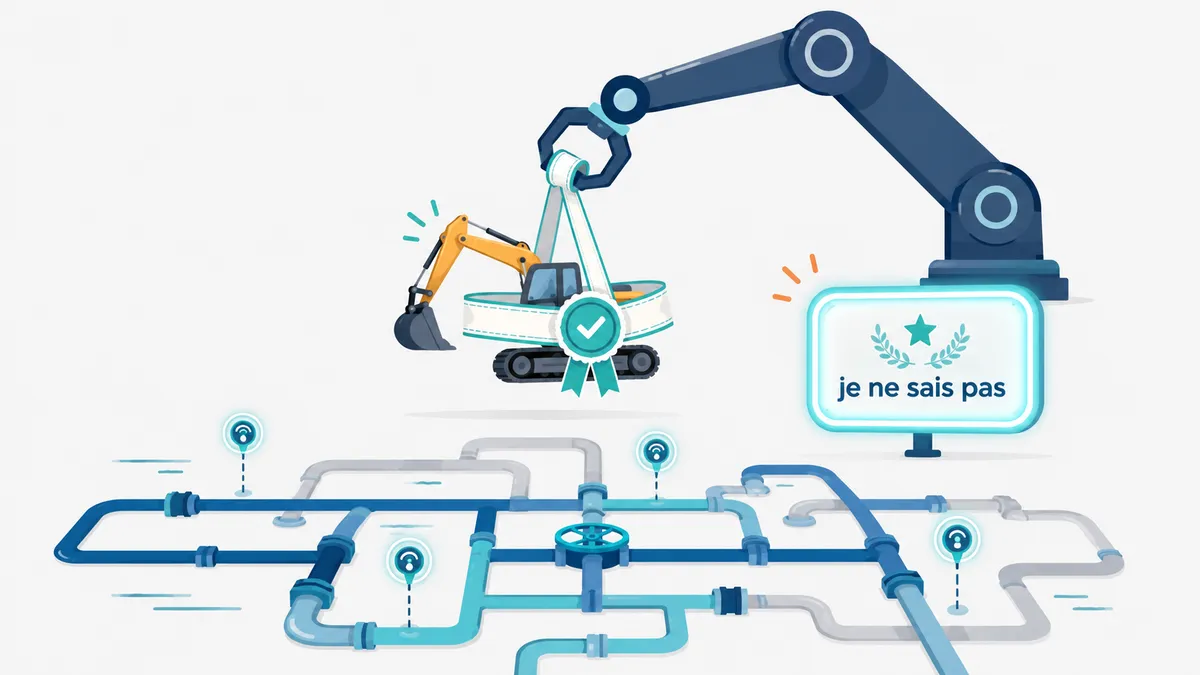
Abstention vérifiable : l'IA qui refuse de faire creuser votre rue pour rien
Des chercheurs transforment une IA de localisation de fuites d'eau fiable à 32 % en un système de décision précis à 96 % — non pas en la rendant plus forte, mais en lui apprenant à prouver quand elle doit s'abstenir. Une leçon d'accountability pour toutes les infrastructures critiques.
2026-08-19·2 min de lecture
Debate Training Reduces Reward Hacking in RLAIF : quand l'élève embobine le correcteur, invitez un contradicteur
Quand un LLM est noté par un juge IA plus faible, il apprend à le manipuler plutôt qu'à résoudre le problème. DeepMind montre qu'un débat adversarial entre deux modèles réduit le reward hacking et garde le juge lucide.